증권사 HTS/MTS, 금융 트레이딩 시스템 및 실시간 대용량 패킷 처리 엔진에서는 세미콜론(;)이나 쉼표(,)로 구분된 수백~수만 개의 종목 코드(Codes) 문자열을 1초에도 수십~수백 번씩 분리해야 하는 상황이 빈번합니다.
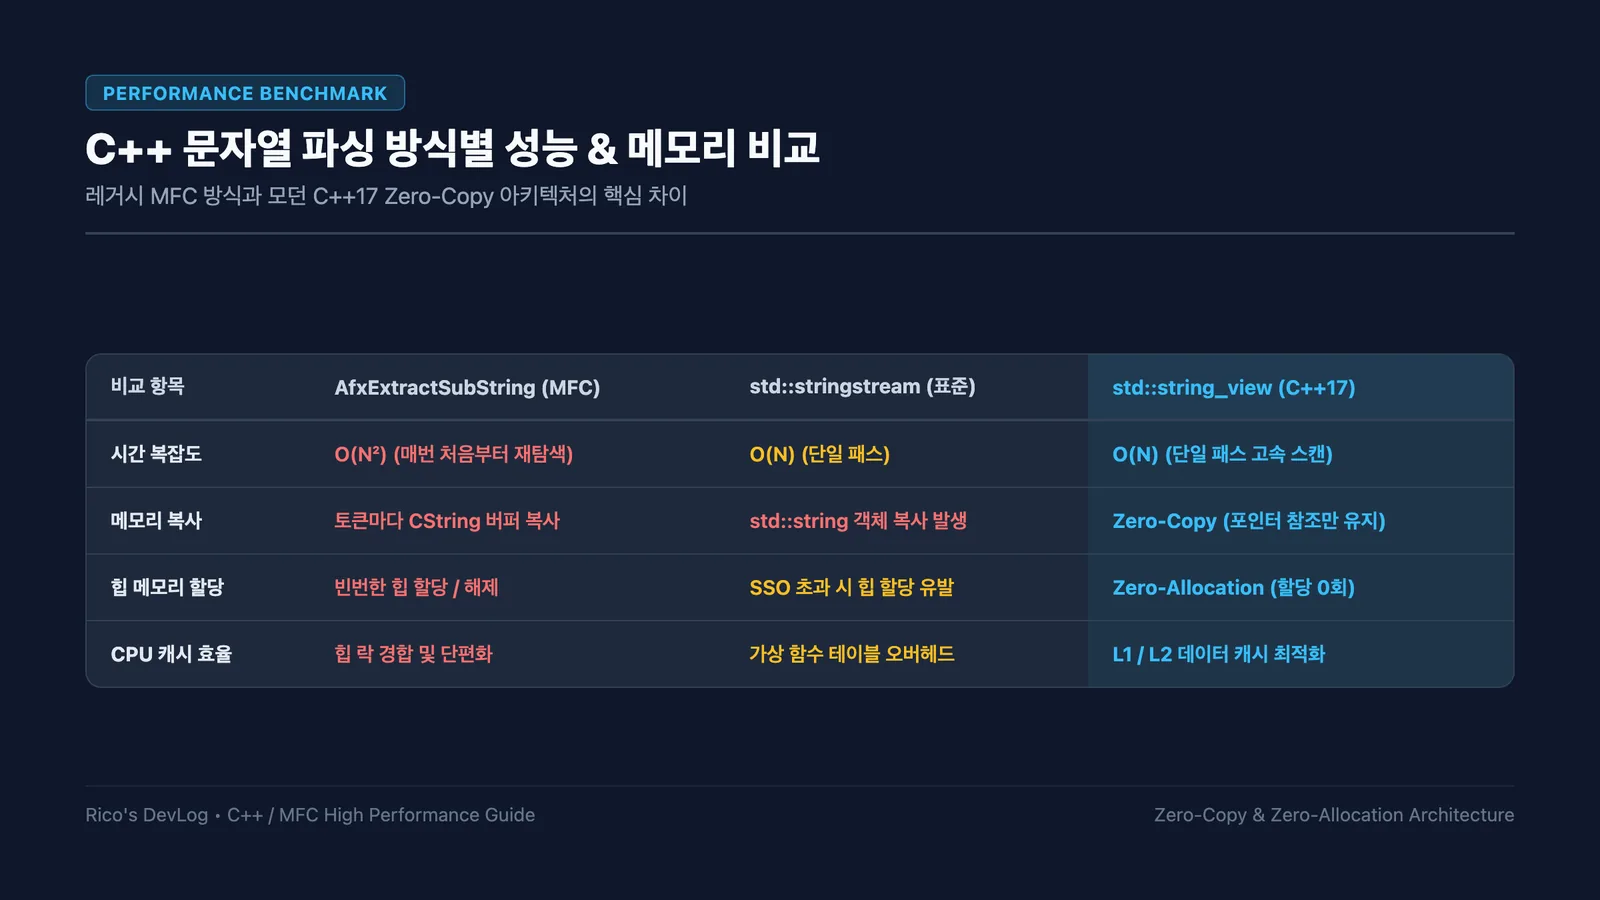
하지만 레거시 MFC 환경에서 무심코 사용하는 AfxExtractSubString, std::stringstream, std::string::substr 기반 파싱 로직은 매 토큰마다 불필요한 동적 힙 할당(Heap Allocation)과 메모리 복사(Memory Copy)를 유발해 심각한 CPU 병목과 캐시 미스(Cache Miss)를 초래합니다.
본 포스팅에서는 동적 힙 메모리 할당을 완전히 제거(Zero-Allocation)하고 메모리 복사를 없애는(Zero-Copy) C++17 std::string_view 기법과 포인터 직접 순회 콜백 패턴을 상세히 정리하고, 실무에서 마주하는 핵심 Q&A까지 체계적으로 공유합니다.
1. 기존 C++ 및 MFC 문자열 파싱의 성능 병목 원인은 무엇일까?
C++ 레거시 환경에서 문자열을 파싱할 때 가장 흔하게 발생하는 성능 저하의 주원인은 비효율적인 반복 탐색 알고리즘과 빈번한 힙 메모리 재할당입니다.
1.1 AfxExtractSubString의 O(N²) 시간 복잡도와 CString 힙 할당
MFC에서 토큰을 추출할 때 자주 사용되는 AfxExtractSubString은 내부적으로 호출될 때마다 문자열의 첫 번째 인덱스부터 구분자 개수를 다시 카운팅하여 $i$번째 토큰을 찾습니다.
// [비효율적인 예시] AfxExtractSubString 기반 파싱
CString strCodes = _T("005930;000660;035420;005380;068270;...");
CString strToken;
int i = 0;
while (AfxExtractSubString(strToken, strCodes, i++, _T(';'))) {
    // 매번 문자열 내부를 처음부터 다시 검색하고 CString 힙 버퍼를 재할당함
    // 토큰이 1,000개라면 최대 500,000번의 불필요한 문자 비교 수행 (O(N^2))
}
토큰 개수가 $N$개일 때 전체 탐색 연산량이 $O(N^2)$로 치솟으며, 매 루프마다 CString 객체가 생성되고 소멸하면서 힙 관리자(Heap Manager)에 막대한 락 경합과 오버헤드를 안깁니다.
1.2 std::stringstream 및 std::string::substr의 메모리 복사 오버헤드
표준 C++ 라이브러리의 std::stringstream과 std::getline 조합 역시 성능 중심의 시스템에서는 피해야 할 패턴입니다.
// [비효율적인 예시] std::stringstream 사용
std::stringstream ss(codes);
std::string item;
while (std::getline(ss, item, ';')) {
    // std::stringstream의 가상 함수 호출 + std::string 동적 메모리 할당
}
std::stringstream은 스트림 객체 생성 시 내부 가상 함수 테이블 참조 및 버퍼 초기화 비용이 큽니다. 또한 토큰 길이가 SSO(Small String Optimization, 보통 15바이트)를 초과하거나 토큰 수가 많아질 경우 std::string의 힙 할당으로 인해 L1/L2 CPU 데이터 캐시 미스가 누적됩니다.
2. 해결책 1: std::string_view 기반의 Zero-Copy 고속 파싱
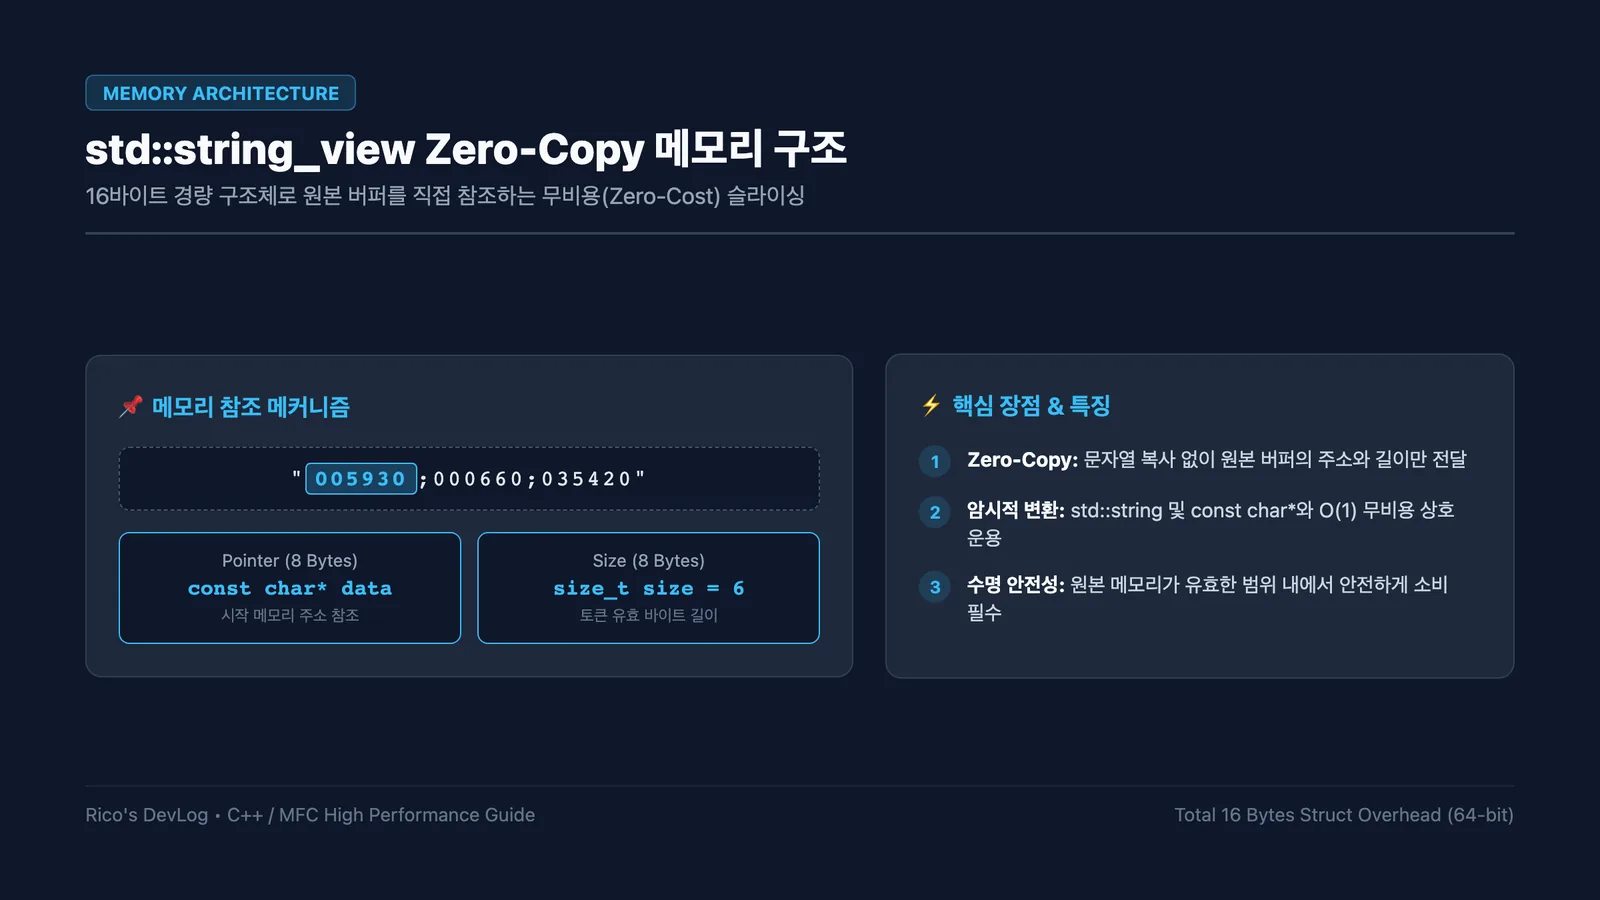
C++17에 도입된 std::string_view는 원본 문자열의 메모리 소유권을 가지지 않고, 시작 포인터(const char*, 8바이트)와 길이(size_t, 8바이트)만을 유지하는 16바이트(64-bit 기준) 초경량 비소유(Non-owning) 뷰 래퍼입니다.
2.1 std::string_view 기반 토크나이징 구현
단 한 번의 문자열 선형 탐색($O(N)$)으로 구분자를 찾아 std::string_view 슬라이스를 생성하는 고성능 함수입니다.
#include <string>
#include <string_view>
#include <vector>

std::vector<std::string_view> SplitCodesFast(std::string_view codes)
{
    std::vector<std::string_view> result;
    // 예상되는 종목 개수만큼 버퍼를 미리 확보하여 vector 재할당(Re-allocation) 방지
    result.reserve(128);

    size_t start = 0;
    size_t end = codes.find(';');

    while (end != std::string_view::npos)
    {
        if (end > start) // 빈 문자열 토큰 방어
        {
            result.emplace_back(codes.data() + start, end - start);
        }
        start = end + 1;
        end = codes.find(';', start);
    }

    // 마지막 토큰 처리
    if (start < codes.size())
    {
        result.emplace_back(codes.data() + start, codes.size() - start);
    }

    return result;
}- Zero-Copy 보장: 문자열의 실제 데이터를 복사하지 않고 포인터 산술 연산으로 슬라이스만 잘라냅니다.
reserve(128):std::vector의 내부 동적 배열이 크기를 늘릴 때 발생하는 지수적 재할당과 메모리 복사를 원천 차단합니다.
3. 해결책 2: 포인터 직접 순회 & 콜백 방식 (Zero-Allocation)
파싱 결과를 std::vector에 담아 반환하는 것조차 벡터 내부 버퍼의 메모리 할당 비용을 발생시킵니다. 실시간 틱 수신 엔진이나 초저지연(Ultra Low Latency) 패킷 처리기에서는 콜백(Callback) 패턴을 통해 힙 할당을 0회로 만드는 Zero-Allocation 아키텍처를 구성할 수 있습니다.
3.1 포인터 직접 순회 템플릿 구현
#include <string>
#include <string_view>

template <typename Func>
inline void ForEachCodeFast(const std::string& codes, Func&& callback)
{
    const char* start = codes.data();
    const char* end = start + codes.size();
    const char* current = start;

    while (current < end)
    {
        if (*current == ';')
        {
            if (current > start)
            {
                callback(std::string_view(start, static_cast<size_t>(current - start)));
            }
            start = current + 1;
        }
        ++current;
    }

    if (start < end)
    {
        callback(std::string_view(start, static_cast<size_t>(end - start)));
    }
}

// [실제 활용 예시]
void ProcessIncomingPacket(const std::string& rawCodes)
{
    ForEachCodeFast(rawCodes, [](std::string_view code) {
        // UI 반영이나 MFC 컨트롤 바인딩이 꼭 필요한 시점에만 CString 변환 수행
        // 비즈니스 로직, 해시맵 키 조회, 패킷 라우팅은 code(string_view)로 직접 처리
    });
}- 단일 패스(Single-pass) 스캔: 포인터를 1바이트씩 전진시키며 구분자를 만나면 즉시 람다 함수로 슬라이스를 넘깁니다.
- Zero-Allocation 달성: 스택과 힙을 통틀어 어떠한 추가 동적 컨테이너도 생성하지 않으므로 CPU L1 캐시 적중률이 극대화됩니다.
4. 실무 개발자가 반드시 알아야 할 핵심 Q&A 및 기술 분석
Q1. SplitCodesFast의 파라미터가 std::string_view일 때, std::string이나 문자열 리터럴을 그대로 넘겨도 되는가?
답변: 완벽하게 동작하며, 비용 $O(1)$의 무비용(Zero-Cost) 암시적 변환이 일어납니다.
std::string_view는 const std::string& 및 const char*를 받는 비-명시적(non-explicit) 생성자를 표준으로 지원합니다. 호출 시 컴파일러가 원본 std::string의 내부 데이터 포인터와 길이(size())를 즉시 추출하여 16바이트 스택 구조체로 조립해 전달하므로 힙 할당이나 복사가 전혀 발생하지 않습니다.
std::string myCodes = "005930;000660;035420";

auto res1 = SplitCodesFast(myCodes);         // std::string 전달 -> O(1) 자동 변환
auto res2 = SplitCodesFast("005930;000660"); // const char* 전달 -> O(1) 자동 변환std::string_view는 원본 메모리를 소유하지 않고 바라보기만(view) 합니다. 따라서 원본 std::string 객체가 스코프를 벗어나 파괴(Dangling)되거나 버퍼가 재할당/수정되기 전에 파싱된 결과를 소비해야 메모리 안전성을 보장할 수 있습니다.
Q2. push_back 대신 emplace_back을 사용하는 이유는 무엇인가?
답변: 불필요한 스택 임시 객체 생성 및 복사/이동 단계를 완전히 생략하기 위해서입니다.
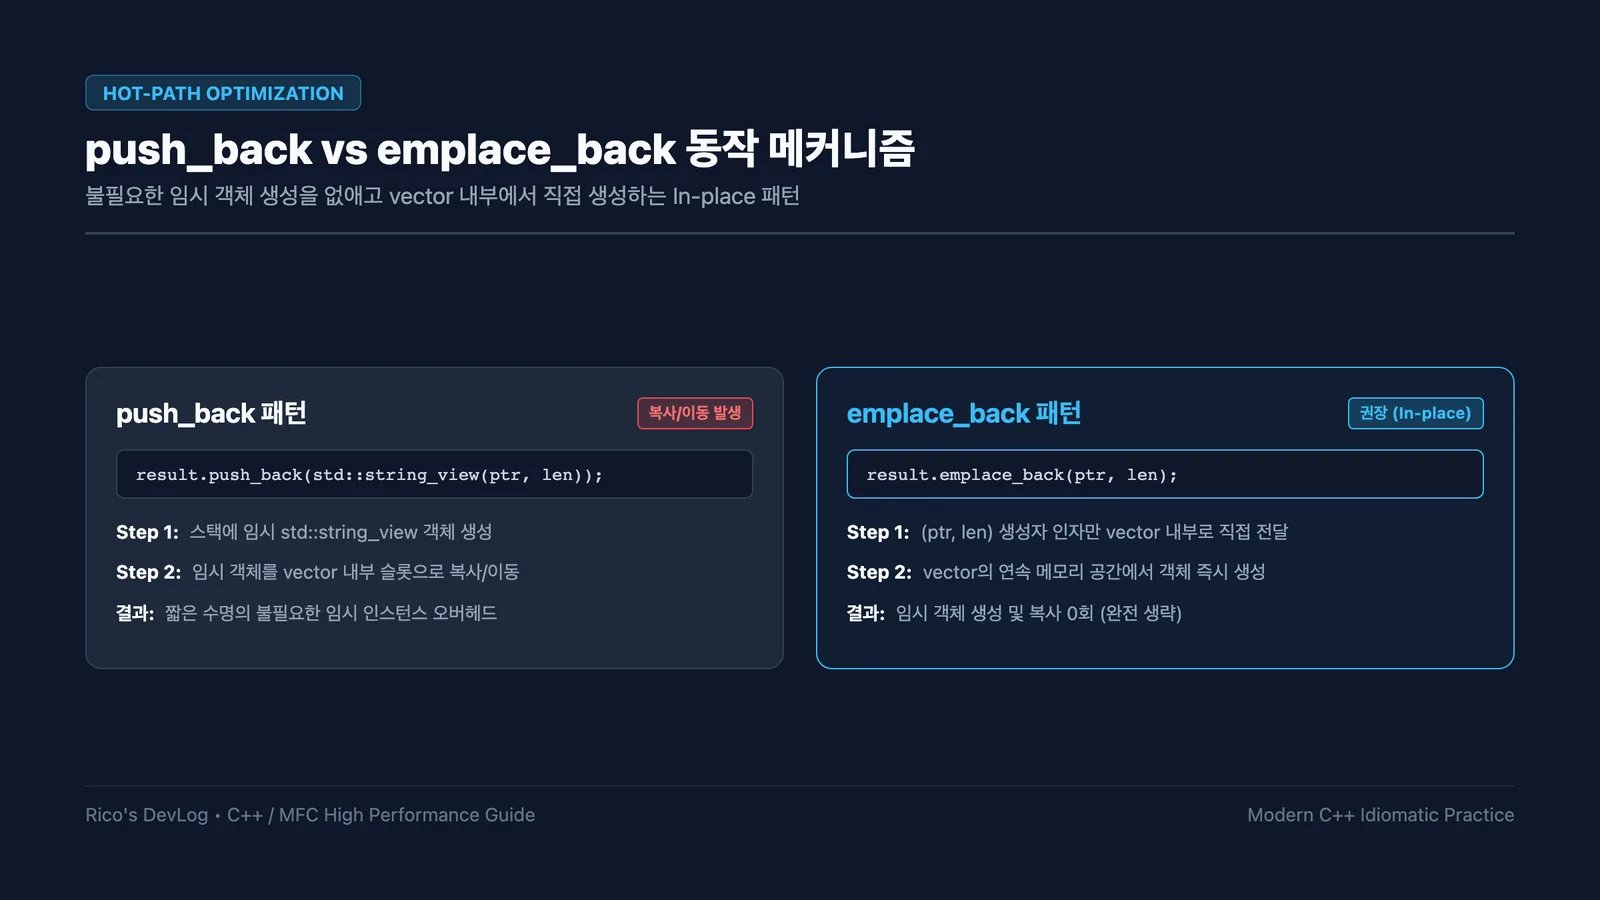
push_back사용 시:- 스택 메모리에 임시
std::string_view객체 인스턴스 생성 - 생성된 임시 객체를
std::vector내부 메모리 슬롯으로 복사 또는 이동(Move)
- 스택 메모리에 임시
emplace_back사용 시 (In-place Construction):- 전달된 생성자 인자
(pointer, length)를std::vector내부 메모리 위치로 직접 전달 - 벡터가 미리 할당해 둔 슬롯에서
std::string_view객체를 직접 생성 (임시 객체 생성 및 복사 생략)
- 전달된 생성자 인자
대량의 루프를 수행하는 핫패스(Hot-path) 최적화에서는 객체 복사 단계를 완전히 배제하고 인자만 전달하는 emplace_back 패턴이 C++ 표준 최적화 관례로 권장됩니다.
5. HTS/MFC 개발 실무를 위한 추가 최적화 전략
1) CString 지연 변환 (Lazy Conversion)
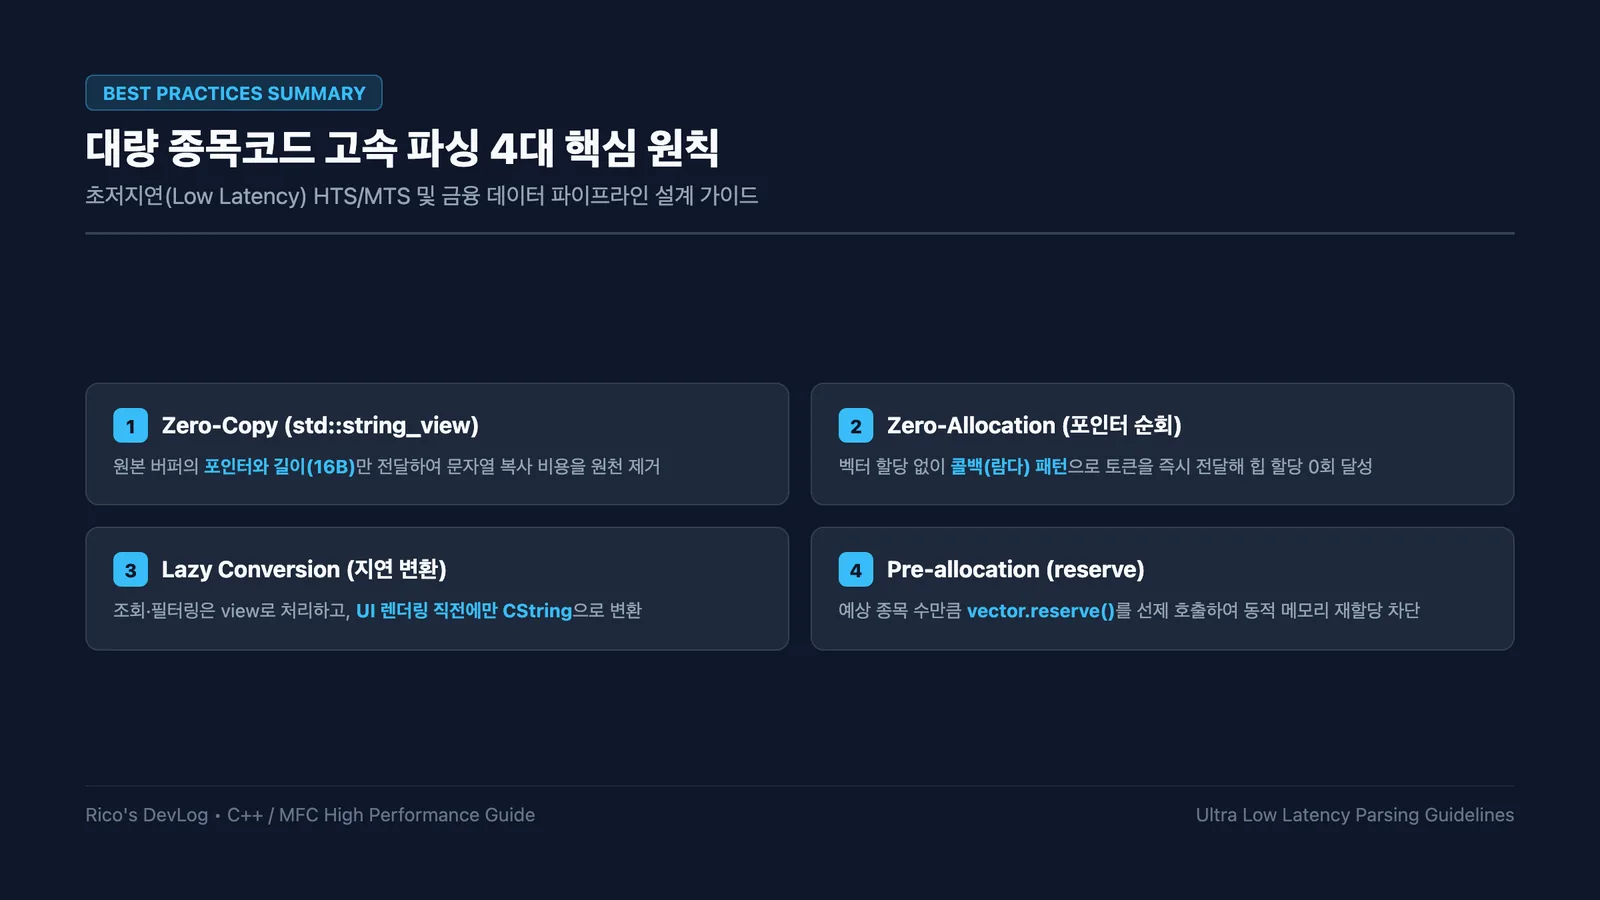
패킷 파싱, 해시맵 키 조회, 조건 필터링 등 비즈니스 로직은 std::string_view 상태로 빠르게 처리하고, 최종적으로 MFC 컨트롤(CListCtrl, CEdit) 렌더링이 필요한 시점에만 CString(code.data(), static_cast<int>(code.size()))로 명시적 변환합니다.
2) 사전 버퍼 추정 (reserve)
한 번에 수신되는 평균 종목 코드 개수(예: 64개 또는 128개)를 파악하여 vector::reserve()를 선제적으로 호출하면 메모리 재할당 오버헤드를 100% 방지할 수 있습니다.
3) SIMD (AVX2/SSE) 벡터화 가속
수천 개 이상의 대규모 데이터 스트림을 실시간으로 파싱해야 하는 초고속 분배기 시스템의 경우 _mm_loadu_si128과 memchr 기반의 SIMD 벡터화 검색을 적용해 16~32바이트 단위로 구분자를 고속 스캔할 수 있습니다.
6. 핵심 요약 (Summary)
- Zero-Copy:
std::string_view를 사용하여 원본 버퍼의 포인터와 길이만 전달함으로써 문자열 복사를 제거합니다. - Zero-Allocation: 포인터 직접 순회 및 콜백(람다) 방식을 적용하여 동적 메모리 할당 횟수를 0으로 줄입니다.
- Modern C++ 최적화:
emplace_back을 통한 In-place 객체 생성과reserve()사전 용량 확보로 극단적인 런타임 성능을 완성합니다.