프롤로그: 오전 9시 00분 00초, 얼어붙는 화면
주식 시장이 열리는 오전 9시 정각, 트레이더의 모니터에는 관심종목 수백 개가 담긴 그리드, 실시간 10호가 창 여러 개, 60개 종목의 호가를 한눈에 보여주는 멀티 시세판, 그리고 전 종목 체결 내역이 폭포수처럼 쏟아지는 실시간 체결창이 동시에 떠 있습니다.
평소 장중에는 아무런 문제 없이 부드럽게 돌아가던 수십 년 역사의 Win32/MFC 기반 데스크톱 트레이딩 플랫폼(HTS)이, 유독 09:00:00 ~ 09:05:00 개장 피크 구간만 되면 마우스 클릭이 먹히지 않거나 창 전환이 1~2초씩 멈칫거리는 현상(UI Freezing)을 겪곤 합니다. 더욱이 단일 정규 거래소뿐 아니라 대체거래소(ATS)까지 동시에 시세를 쏟아내는 복수 거래소 환경이 도래하면서 실시간 패킷 유입량은 기존 대비 2배 이상 급증했습니다.
이 시리즈에서는 수백만 줄 규모의 거대한 레거시 C++/MFC 코드베이스를 전면 재작성(Rewrite)하지 않고도, Lock-Free RCU/CoW 기반의 고성능 인메모리 시세 엔진(MarketDataEngine)과 화면 렌더링 디커플링 파이프라인을 이식하여 개장 피크 구간 최대 UI 지연 시간을 1,531ms에서 15ms로 99% 단축하고 실시간 시세 처리량을 3배 이상 끌어올린 전 과정을 6부작에 걸쳐 상세히 공유합니다.
그 첫 번째 이야기로, 왜 전통적인 Win32 이벤트 드리븐 아키텍처가 초고빈도 실시간 스트림 앞에서 무너지는지 그 구조적 병목을 해부해 보겠습니다.
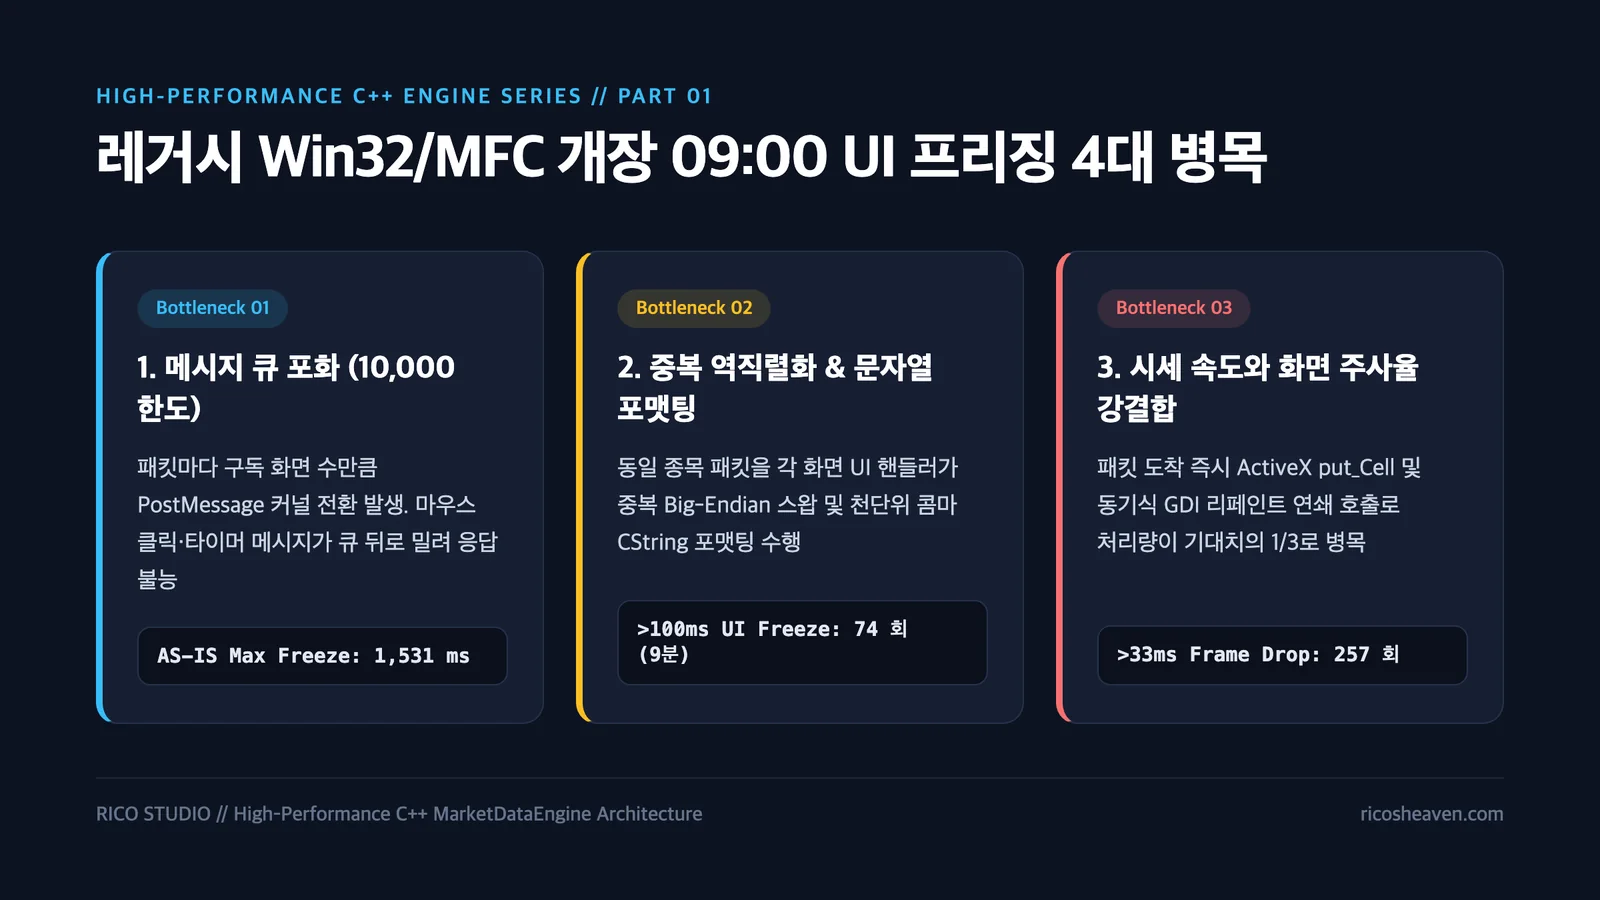
1. 전통적인 레거시 시세 수신 파이프라인(AS-IS)의 구조
수십 년간 안정적으로 운영되어 온 대부분의 Win32/MFC 클라이언트 아키텍처는 윈도우 메시지 큐(PostMessage / SendMessage)를 중심으로 설계되어 있습니다.
flowchart LR
    subgraph NetThread["네트워크 수신 레이어"]
        A["소켓 수신 버퍼"] --> B["프레임 디코더 / 압축 해제"]
    end
    subgraph Router["구독 라우터 (SubscriptionRouter)"]
        B --> C["종목별 구독 화면(HWND) 탐색"]
        C -->|"패킷마다 PostMessage"| D["Win32 UI 메시지 큐 (한도: 10,000개)"]
    end
    subgraph UIThread["단일 메인 UI 스레드 (병목 집중)"]
        D --> E["OnRealtimePacket(WM_USER + N)"]
        E --> F["1. Big-Endian → Little-Endian 바이트 스왑"]
        F --> G["2. 등락률·대비·호가합계 계산 및 천단위 포맷팅"]
        G --> H["3. GDI / ActiveX 그리드 셀 즉시 갱신 (Invalidate / Redraw)"]
    end
얼핏 보면 매우 직관적이고 단순한 이벤트 기반 구조입니다. 하지만 초당 수만 건의 시세 패킷이 쏟아지고 사용자가 여러 개의 무거운 화면을 동시에 열어두는 순간, 이 파이프라인은 네 가지 치명적인 병목을 드러냅니다.
2. 장 시작 프리징을 유발하는 4대 구조적 병목
병목 ①: Win32 메시지 큐 포화와 PostMessage 오버헤드
Windows OS에서 각 GUI 스레드의 메시지 큐 기본 한도는 10,000개(USERPostMessageLimit)입니다.
- 개장 직후 초당 수천~수만 건의 체결·호가 패킷이 유입될 때, 같은 종목을 구독 중인 화면(
HWND)이 5개라면 라우터는 패킷 1개당 5번의PostMessage커널 전환을 일으킵니다. - 큐에 쌓인 수천 개의 사용자 정의 시세 메시지(
WM_USER + α)가 앞줄을 가득 메우면, 정작 사용자가 클릭한 마우스 이벤트(WM_LBUTTONDOWN)나 키보드 입력, 혹은 타이머 메시지(WM_TIMER)는 큐 맨 뒤로 밀려나 수백 ms에서 수 초 동안 처리되지 못합니다.
병목 ②: 동일 패킷에 대한 $N$번의 중복 역직렬화 및 엔디안 변환
네트워크 회선을 타고 들어오는 금융 원시 패킷(Wire Packet)은 대개 네트워크 바이트 오더(Big-Endian)와 고정 길이 ASCII 문자열로 압축되어 있습니다.
- 기존 구조에서는 각 화면(
WatchlistView,OrderBookView,MultiQuoteCellWnd등)이 패킷 포인터나 복사본을 전달받은 뒤, 각 화면의 UI 핸들러 내부에서 독자적으로 4바이트/8바이트 엔디안 스왑(_byteswap_ulong,_byteswap_uint64)과 구조체 파싱을 반복했습니다. - 삼성전자 한 종목의 호가 패킷 1개가 들어왔을 때, 이를 보고 있는 4개의 화면이 메인 UI 스레드 위에서 똑같은 바이트 스왑과 가격 역산 로직을 4번 중복 실행하고 있었던 셈입니다.
병목 ③: 메인 UI 스레드에서의 문자열 포맷팅과 메모리 할당
트레이딩 화면의 그리드 셀 하나를 채우기 위해서는 생각보다 많은 연산이 필요합니다.
- 부호 판별(상한/상승/보합/하락/하한), 전일대비 등락률($\frac{\text{현재가} - \text{기준가}}{\text{기준가}} \times 100$) 부동소수점 연산, 천 단위 콤마(
,) 삽입(sprintf/CString::Format), 거래대금 단위 축약(백만/억) 등이 모두 메인 UI 스레드에서 수행됩니다. - 200종목이 등록된 관심종목 창에서 초당 1,000번의 체결이 발생하면, UI 스레드는 오직 문자열을 조립하고
CString힙 메모리를 할당·해제하는 데만 CPU 시간을 낭비합니다.
병목 ④: 시세 수신 속도와 화면 주사율(FPS)의 강결합
인간의 눈은 초당 20~30프레임(33~50ms 간격) 이상의 숫자 변화를 개별적으로 인지하기 어렵습니다.
- 그러나 레거시 파이프라인은 패킷이 도착할 때마다(Event-Driven) 곧바로 그리드 셀에 값을 밀어 넣고(
SetCell/put_Cell) GDIInvalidateRect를 호출했습니다. - 특히 COM 기반 ActiveX 그리드 컨트롤(
VSFlexGrid계열)이나 수십 개의 자식 윈도우를 가진 화면에서 1ms 간격으로 셀 값을 갱신하면, 내부 레이아웃 재계산과 동기식 GDI 리페인트가 연쇄적으로 일어나면서 단일 프레임 렌더링이 30ms~100ms씩 블로킹됩니다.
3. "추측하지 말고 계측하라" — 비침투형 마이크로 프로파일러 설계
아키텍처를 뜯어고치기 전에 가장 먼저 한 일은 "어디서 몇 마이크로초($\mu s$)를 쓰고 있는가?"를 운영 환경과 동일한 조건에서 정밀하게 측정하는 경량 프로파일러(EngineProfiler)를 심는 것이었습니다.
프로파일러 자체가 성능을 떨어뜨리지 않도록 다음과 같은 원칙으로 설계했습니다:
- QPC(
QueryPerformanceCounter) 기반 마이크로초 계측:GetTickCount()(15.6ms 해상도)로는 잡아낼 수 없는 수십 $\mu s$ 단위의 파싱·바인딩·페인팅 지연을 측정합니다. - 스레드 로컬 / 원자적 카운터 누적 + 주기적 CSV Flush: 매 틱마다 파일 I/O를 일으키지 않고,
std::atomic<uint64_t>카운터에 누적한 뒤 1초~5초 주기로만 로그 파일에 기록합니다. - INI 설정 스위치(
Profiler.Enable=0/1): 평소 운영 시에는 분기 예측 비용조차 거의 없는0상태로 두고, 개장 피크 테스트 시에만1로 켜서 AS-IS와 TO-BE를 동일 시간대·동일 종목군에서 비교합니다.
// RAII 기반 마이크로초 구간 계측 스코프 예시
struct ScopedTimerUs {
    std::atomic<uint64_t>& totalUs_;
    std::atomic<uint64_t>& maxUs_;
    LARGE_INTEGER start_;

    ScopedTimerUs(std::atomic<uint64_t>& totalUs, std::atomic<uint64_t>& maxUs)
        : totalUs_(totalUs), maxUs_(maxUs) {
        ::QueryPerformanceCounter(&start_);
    }

    ~ScopedTimerUs() {
        LARGE_INTEGER end, freq;
        ::QueryPerformanceCounter(&end);
        ::QueryPerformanceFrequency(&freq);
        const uint64_t elapsedUs =
            static_cast<uint64_t>(end.QuadPart - start_.QuadPart) * 1'000'000ULL /
            static_cast<uint64_t>(freq.QuadPart);

        totalUs_.fetch_add(elapsedUs, std::memory_order_relaxed);
        uint64_t prevMax = maxUs_.load(std::memory_order_relaxed);
        while (elapsedUs > prevMax &&
               !maxUs_.compare_exchange_weak(prevMax, elapsedUs, std::memory_order_relaxed)) {}
    }
};
이 프로파일러를 통해 개장 직후 9분(540초) 동안 측정한 AS-IS의 실상은 충격적이었습니다:
- 단일 관심종목 화면에서만 최대 틱 처리 시간이
1,531ms(1.53초 동안 UI 완전 정지)까지 치솟았고, - 100ms를 초과하는 체감 멈춤(
>100ms Freeze)이 74회, 33ms(30fps 기준) 초과 지연이 257회 발생했으며, - UI 스레드가 앞선 패킷을 그리느라 바쁜 사이 후속 시세 알림이 밀리면서, 동일 시간 동안 실제 화면에 반영된 시세 건수가 기대치의 1/3 수준으로 병목되고 있었습니다.
4. 아키텍처 재설계의 4대 핵심 목표
문제가 명확해졌으니 해법의 방향도 명확해졌습니다. 기존 수백 개의 화면 코드를 깨뜨리지 않으면서 성능을 근본적으로 뒤바꾸기 위해 다음 4가지 설계 원칙을 세웠습니다.
- 통신-캐시-UI의 완전한 디커플링 (Decoupling):
네트워크 패킷 수신 즉시 백그라운드 워커가 엔디안 변환과 정규화를 딱 1번만 수행하여 중앙 인메모리 스냅샷(SymbolSnapshot)을 갱신한다. - 뮤텍스 대기 없는 읽기 (Lock-Free RCU & Copy-on-Write):
백그라운드 워커가 시세를 쓰는 동안에도 UI 스레드는 단 1나노초의 뮤텍스 블로킹 없이 최신 불변(Immutable) 스냅샷을 읽어간다. - 생산자 속도와 소비자(화면) 주사율의 분리 (Conflation & Frame Budget):
시세가 초당 10,000번 변하더라도 화면은 인간의 눈과 모니터 주사율(30~50ms)에 맞춰 최종 상태(Latest State)만 묶어서(Coalescing) 한 번만 그린다. - 100% 안전한 Dual-Path 아키텍처:
설정 파일(UseDataManager=0/1) 하나로 언제든 기존 레거시 경로와 신규 엔진 경로를 전환할 수 있도록 설계하여, 운영 리스크를 제로(0)로 통제한다.
다음 [2부]에서는 이 아키텍처의 심장부인 종목 해시 샤딩(Sharding)과 Lock-Free RCU(RcuSnapshotSlots) + Copy-on-Write 인메모리 캐시 엔진을 C++17로 어떻게 구현했는지 코드 레벨에서 살펴보겠습니다.