지난 줄거리 및 이번 글의 목표
[1부]에서는 레거시 Win32/MFC 트레이딩 클라이언트가 개장 직후(09:00) 시세 폭주 시 왜 멈추는지 살펴보았습니다. 모든 패킷을 PostMessage로 UI 스레드에 밀어 넣고, 각 화면이 중복으로 바이트 스왑·문자열 포맷팅·즉시 리페인트를 수행하는 구조가 문제의 핵심이었습니다.
이를 해결하기 위해 우리는 통신 레이어와 UI 레이어 사이에 중앙 집중형 고성능 인메모리 시세 엔진인 MarketDataEngine을 도입했습니다. 하지만 중앙 인메모리 캐시를 만들 때 가장 흔히 범하는 실수가 있습니다. 바로 std::mutex나 SRWLOCK 하나로 전체 종목 맵을 감싸는 것입니다.
백그라운드 워커 스레드들이 초당 수만 번 시세를 갱신(Write)할 때, 메인 UI 스레드가 화면을 그리기 위해 같은 락(Lock)을 잡고 대기(Wait)한다면 어떻게 될까요? 결국 UI 스레드가 백그라운드 워커와 락 경합(Lock Contention)을 벌이느라 다시 멈추는 역설이 발생합니다.
이번 [2부]에서는 쓰기 스레드 간의 경합을 없애는 도메인/종목 해시 샤딩(Sharding)과, 읽기 스레드(UI)가 무잠금(Lock-Free)으로 최신 스냅샷을 조회하는 RCU(Read-Copy-Update) + Copy-on-Write 아키텍처를 어떻게 설계했는지 자세히 다루겠습니다.
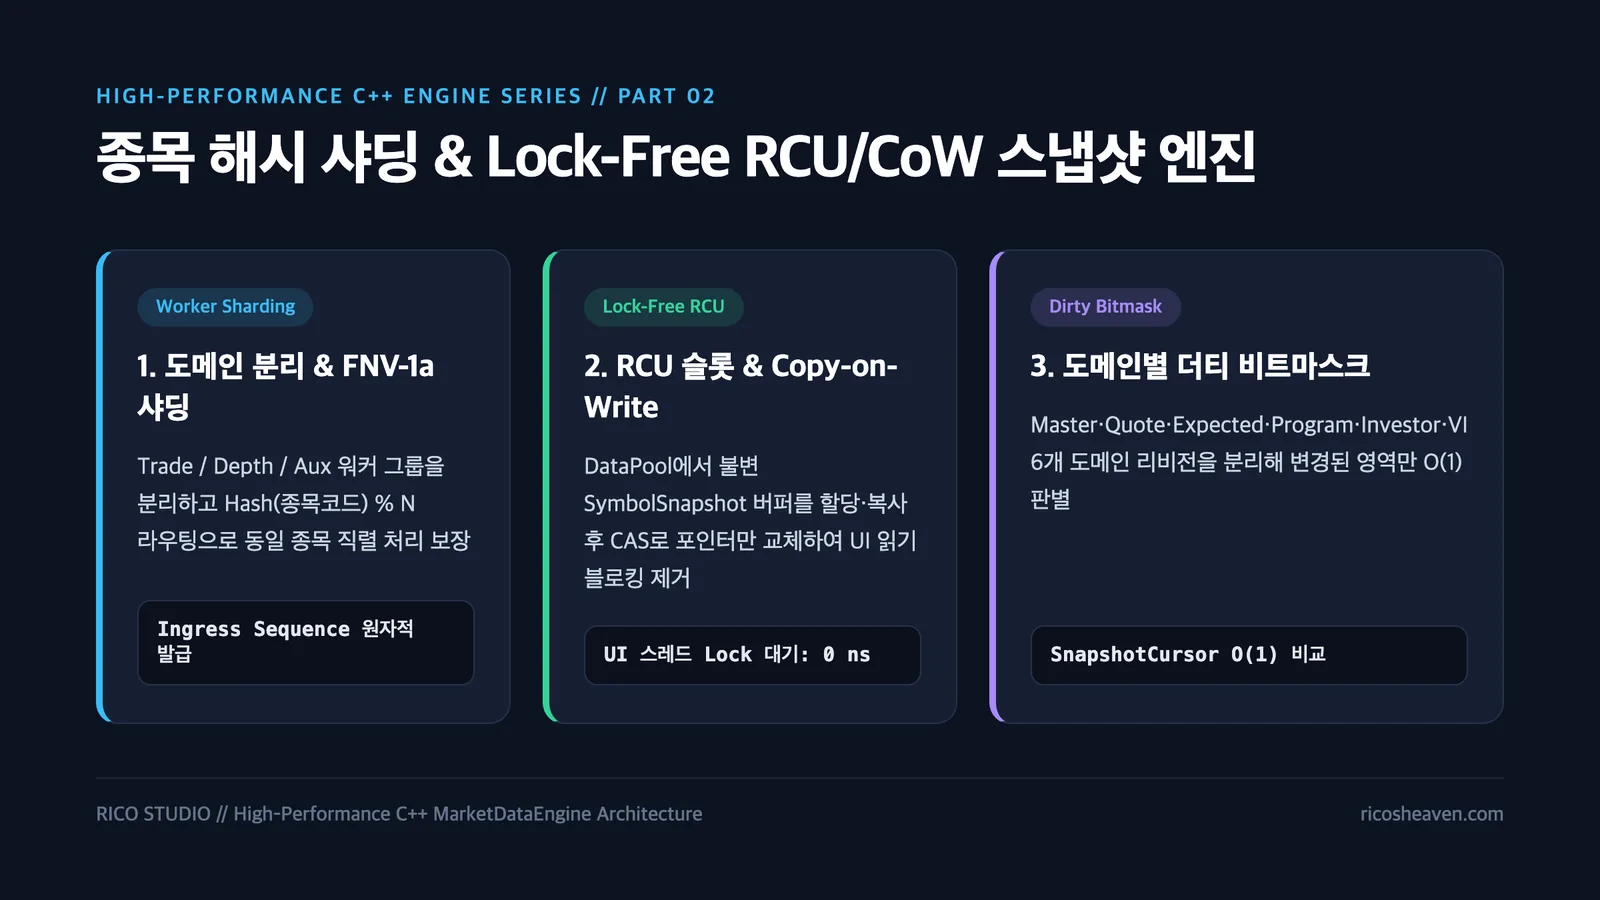
1. 쓰기 병목 격리: 도메인 분리 + 종목 해시 샤딩 (Worker Sharding)
실시간 시세 패킷은 성격과 빈도가 전혀 다른 여러 도메인으로 나뉩니다.
- 체결(Trade) 및 예상체결(Expected): 빈도가 매우 높고 현재가·대비·누적거래량을 갱신
- 호가(OrderBook Depth): 패킷 크기가 크고(10단계 매도/매수 가격·잔량·LP 잔량 등 약 1KB) 연산량이 많음
- 기타 보조 시세(프로그램 매매, 투자자별, VI, 특이신호 등): 빈도는 상대적으로 낮지만 파싱 규칙이 다양함
만약 단일 워커 스레드가 이 모든 패킷을 순서대로 처리한다면, 1KB짜리 호가 패킷 100개를 파싱하는 동안 뒤에 줄 서 있는 가벼운 체결 패킷 수백 개가 지연(Head-of-Line Blocking)됩니다. 반대로 아무 기준 없이 스레드 풀에서 패킷을 꺼내 처리하면, 동일 종목의 연속된 체결 패킷 2개가 서로 다른 코어에서 동시에 처리되면서 순서가 뒤집히는 레이스 컨디션(Race Condition)이 발생합니다.
우리는 이 두 마리 토끼를 잡기 위해 도메인별 샤드 그룹 + 종목 코드 해시(FNV-1a) 라우팅 구조를 설계했습니다.
flowchart TD
    A["실시간 패킷 인입 (Ingress)"] --> B["단조 증가 Ingress Sequence 번호 발급 (atomic fetch_add)"]
    B --> C{"전문 도메인 분류"}
    C -->|"체결 / 예상체결"| D["Trade Shard Group (N개 워커)"]
    C -->|"10호가 (Depth)"| E["Depth Shard Group (M개 워커)"]
    C -->|"보조 시세 / 초기 조회"| F["Aux Shard Group"]
    D -->|"Hash(종목코드) % N"| G["동일 종목 체결은 항상 동일 워커가 순서대로 처리"]
    E -->|"Hash(종목코드) % M"| H["동일 종목 호가는 항상 동일 워커가 순서대로 처리"]
핵심 설계 포인트
- Ingress Sequence 즉시 발급: 패킷이 엔진 입구에 도착하는 즉시
m_ingressOrder.fetch_add(1, std::memory_order_relaxed)로 전역 단조 증가 시퀀스 번호를 부여합니다. - 종목별 순서 보장 (Per-Symbol Serial Execution): 같은 도메인 내에서 동일 종목 코드(예:
005930)는Hash(code) % shardCount에 의해 항상 동일한 샤드 워커 큐로만 들어갑니다. 따라서 같은 도메인 내에서는 락 없이도 패킷 처리 순서가 100% 보장됩니다. - 코어 어피니티(Core Affinity) 분산: 각 워커 스레드는 0번 코어(메인 UI 스레드가 주로 사용하는 코어)를 피하고 나머지 물리/논리 코어에 고르게 바인딩하여 UI 스레드의 캐시 오염과 컨텍스트 스위칭을 최소화했습니다.
2. 읽기 병목 제거: Lock-Free RCU(RcuSnapshotSlots)와 Copy-on-Write
이제 서로 다른 도메인 워커(예: Trade 워커와 Depth 워커)가 같은 종목의 스냅샷(SymbolSnapshot)을 갱신하거나, UI 스레드가 그 스냅샷을 읽어가는 순간을 생각해 봅시다.
C++11/17 표준에서 std::shared_ptr<const SymbolSnapshot>는 제어 블록(Reference Count) 증감 자체는 원자적이지만, 동일한 shared_ptr 인스턴스 변수에 대해 한 스레드가 쓰기(store)를 하고 다른 스레드가 읽기(load)를 하면 데이터 레이스(Undefined Behavior)가 발생합니다. (C++20에 와서야 std::atomic<std::shared_ptr<T>>가 정식 도입되었으나, 많은 상용 컴파일러 구현체에서 내부 스핀락을 사용하는 한계가 있습니다.)
우리는 완전한 Lock-Free 읽기/쓰기를 달성하면서 종목별 거래소 슬롯(Primary, Alternative, Consolidated)을 관리하기 위해 지수 백오프(Exponential Backoff) CAS 기반의 RCU(Read-Copy-Update) + Copy-on-Write 패턴을 적용했습니다.
sequenceDiagram
    participant W as "백그라운드 Shard Worker (Writer)"
    participant S as "SymbolContext (Atomic RCU Slot)"
    participant UI as "메인 UI 스레드 / ScreenWorker (Reader)"

    Note over S: 현재 게시된 스냅샷: Snapshot v1 (불변, const)
    UI->>S: GetSnapshot() 호출 (락 없이 v1 포인터 즉시 획득!)
    W->>S: 현재 포인터(v1) Load
    W->>W: Object Pool에서 새 버퍼(v2) 할당 후 v1 내용 복사 (Copy-on-Write)
    W->>W: v2에 빅엔디안 스왑된 신규 체결/호가 데이터 반영
    W->>S: CAS(expected=v1, desired=v2) 원자적 교체!
    Note over UI: UI는 읽던 v1을 끝까지 안전하게 참조 후 자동 반납
    UI->>S: 다음 프레임 GetSnapshot() 호출 → 즉시 v2 획득!
Copy-on-Write(CoW) 업데이트 루프의 핵심 구조
// 백그라운드 워커가 특정 종목의 스냅샷을 무잠금(Lock-Free CAS)으로 갱신하는 과정
template <typename MutateFunc>
std::shared_ptr<const SymbolSnapshot> UpdateSymbolRcu(
    SymbolSlot& slot,
    ObjectPool<SymbolSnapshot>& pool,
    MutateFunc&& mutate)
{
    uint32_t spinCount = 0;
    while (true) {
        // 1. 현재 게시된 불변 스냅샷(oldSnap)을 원자적으로 로드
        std::shared_ptr<const SymbolSnapshot> oldSnap = slot.LoadAcquire();

        // 2. 메모리 풀(Object Pool)에서 새 스냅샷 버퍼를 할당하고 기존 상태를 복사(CoW)
        std::shared_ptr<SymbolSnapshot> newSnap = pool.Acquire();
        if (oldSnap) {
            *newSnap = *oldSnap; // POD 수준 고속 메모리 복사
        } else {
            newSnap->InitializeDefaults();
        }

        // 3. 복사본(newSnap)에 이번 패킷의 도메인 변경분만 적용 (Mutate)
        //    만약 다른 도메인 워커와 CAS가 충돌해 재시도하더라도,
        //    최신 oldSnap 위에 이번 도메인 변경분을 다시 입히므로 데이터 유실이 없음!
        if (!mutate(*newSnap)) {
            return oldSnap; // 과거/중복 패킷이거나 변경 사항이 없으면 즉시 중단
        }
        newSnap->revision = oldSnap ? (oldSnap->revision + 1) : 1;

        // 4. CAS(Compare-And-Swap)로 포인터를 원자적 교체
        if (slot.CompareExchangeRelease(oldSnap, std::const_pointer_cast<const SymbolSnapshot>(newSnap))) {
            return newSnap; // 게시 성공!
        }

        // 5. 경합 발생 시 지수 백오프(PAUSE 명령어 -> SwitchToThread) 수행 후 재시도
        CasBackoff::Pause(spinCount);
    }
}
왜 이 구조가 강력한가?
- UI 스레드의 읽기 지연 = 0 (Wait-Free 수준):
UI 스레드는slot.LoadAcquire()로std::shared_ptr<const SymbolSnapshot>하나만 가져오면 됩니다. 스냅샷 객체는 한 번 게시된 이후 절대로 수정되지 않는 불변(Immutable) 객체이므로, UI 스레드가 화면을 그리는 도중 백그라운드에서 100번의 새로운 체결이 일어나도 데이터 찢어짐(Tearing)이나 락 대기가 전혀 발생하지 않습니다. - 도메인 간 CAS 충돌 시에도 변경분 100% 보존:
예를 들어Trade 워커와Depth 워커가 동시에 같은 종목을 수정해Depth 워커의 CAS가 한 번 실패하더라도, 루프 다음 턴에서Trade 워커가 방금 게시한oldSnap을 다시 읽어 그 위에Depth변경분(mutate)을 입히므로 어느 한쪽의 데이터도 덮어써지거나 유실되지 않습니다. - TLS/Lock-Free Object Pool(
DataPool)을 통한 힙 할당 제거:
매 패킷마다new SymbolSnapshot을 호출하면 OS 힙 할당자(malloc/HeapAlloc)에서 다시 전역 락 경합이 일어납니다. 이를 방지하기 위해 프리리스트(Free-List) 기반의 객체 풀(DataPool)을 두어, UI가 다 읽고 참조 카운트가 0이 된 스냅샷 메모리가 커스텀 Deleter를 통해 즉시 풀로 회수·재사용되도록 설계했습니다.
3. 세분화된 더티 마스크 (Domain Dirty Bitmask)
SymbolSnapshot 안에는 수백 개의 필드가 존재합니다. 체결 패킷 하나가 들어왔을 때 호가 10단계는 변하지 않았고, 호가 패킷이 들어왔을 때 프로그램 매매 수치는 변하지 않았습니다.
화면이 스냅샷을 읽을 때 "어떤 도메인이 몇 번째 리비전(revision)까지 변했는가?"를 $O(1)$에 판별할 수 있도록, 스냅샷 내부에 도메인별 단조 증가 시퀀스를 분리하여 기록했습니다:
enum DomainDirtyFlags : uint32_t {
    DOM_NONE     = 0,
    DOM_MASTER   = 1 << 0, // 현재가, 대비, 등락률, 누적거래량, 고/저/시가
    DOM_QUOTE    = 1 << 1, // 10단계 매도/매수 호가 및 잔량
    DOM_EXPECTED = 1 << 2, // 동시호가 예상체결가 / 예상수량
    DOM_PROGRAM  = 1 << 3, // 프로그램 매매
    DOM_INVESTOR = 1 << 4, // 투자자별 매매동향
    DOM_VI       = 1 << 5, // 정적/동적 VI 발동 및 기준가격
};
각 화면은 자신이 마지막으로 렌더링한 도메인별 커서(SnapshotCursor)를 들고 있다가, 새 스냅샷과 비교하여 실제로 변경된 도메인 비트만 골라내어 최소한의 UI 갱신을 수행합니다.
다음 이야기 예고
이제 백그라운드에서 패킷을 빠르게 받아 무잠금 스냅샷으로 게시하는 엔진의 뼈대가 완성되었습니다. 하지만 실전 금융 시장에는 훨씬 까다로운 도메인 난제가 기다리고 있었습니다.
- "정규 거래소(Primary)와 대체거래소(ATS)에서 따로 날아오는 10호가를 어떻게 실시간으로 합산하여 통합 10호가를 만들 것인가?"
- "초기 조회(Request/Reply) 응답이 오는 도중에 실시간 체결 패킷이 먼저 도착하면, 어떻게 과거 데이터가 최신 데이터를 덮어쓰지 않게 막을 것인가?"
다음 [3부]에서는 복수 거래소 실시간 호가 합성 알고리즘과 비동기 순서 역전(Out-of-Order) 정복기를 다루겠습니다.