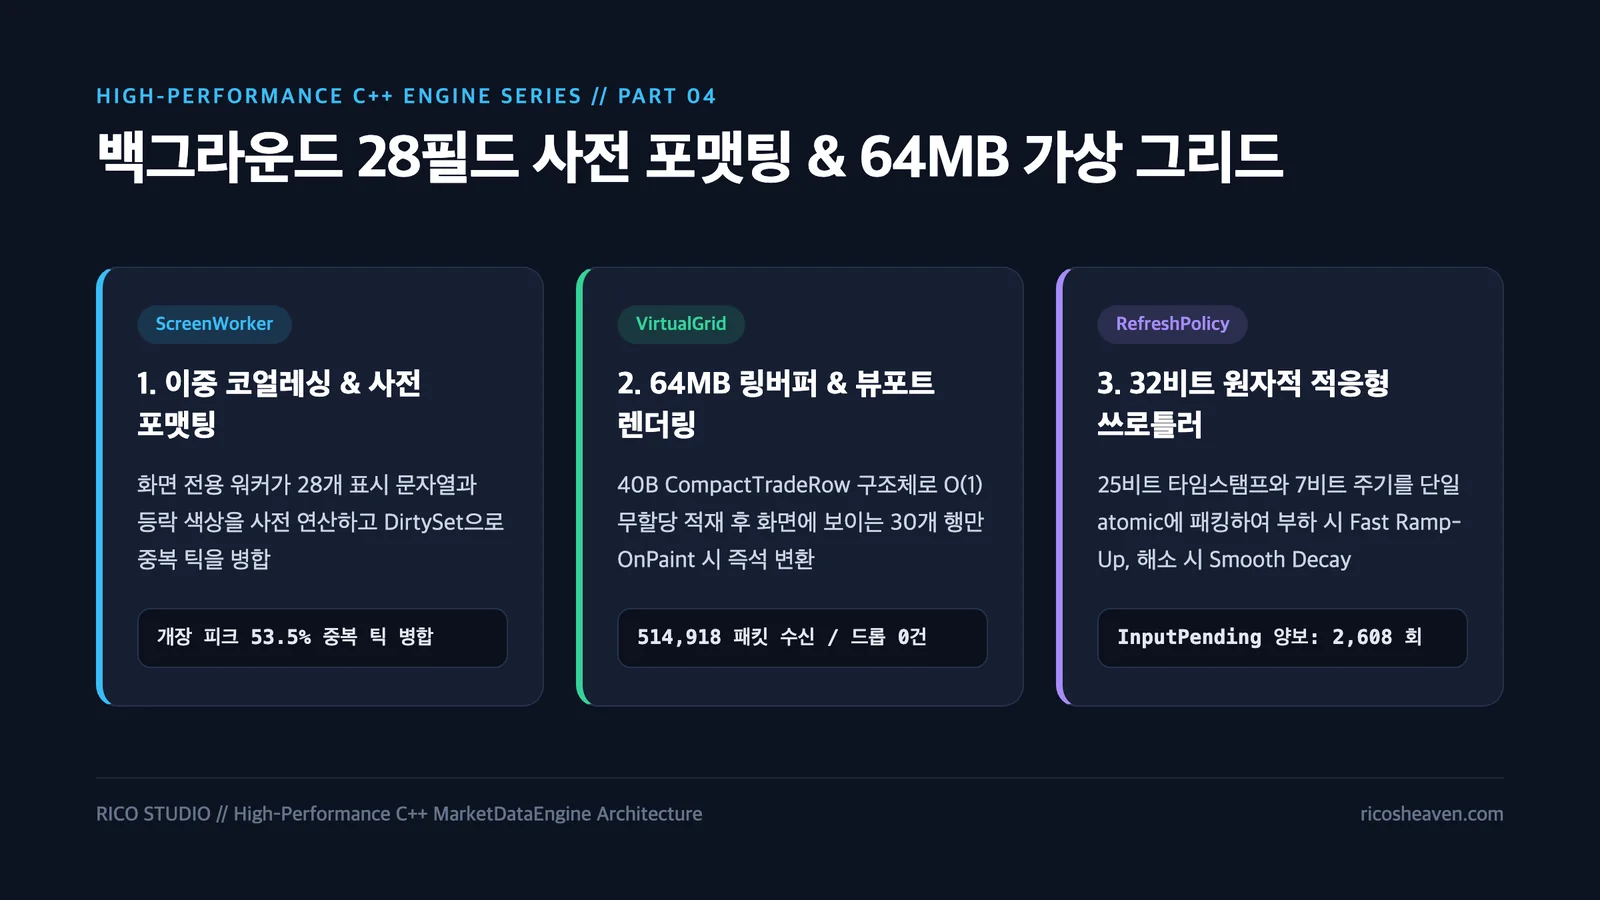
들어가는 글: 스냅샷이 빨라져도 그리드가 느리면 소용없다
[2부]와 [3부]를 통해 백그라운드에서 패킷을 파싱하고 무잠금 RCU 스냅샷(SymbolSnapshot)으로 합성하는 과정은 마이크로초($\mu s$) 단위로 빨라졌습니다.
하지만 실제 화면(View)들이 이 스냅샷을 소비하는 방식을 프로파일링해 보니, 여전히 메인 UI 스레드에서 두 가지 거대한 부하가 관찰되었습니다:
- 관심종목 그리드(
WatchlistView)의 포맷팅 병목:
200개 종목이 등록된 그리드에서 100ms마다 변경된 종목들의 현재가, 대비, 등락률(+3.45%), 거래량(12,345,678), 거래대금, 호가 등을 천 단위 콤마 문자열로 변환(sprintf/Format)하고 등락 색상(RGB)을 결정하는 작업이 모두 UI 스레드의OnTimer안에서 돌고 있었습니다. - 전 종목 실시간 체결 스트림(
TimeAndSalesView)의 행 삽입 병목:
시장 전체(수천 종목)에서 체결이 일어날 때마다 그리드 최상단(0번 행)에 새 행을 끼워 넣고(InsertRow(0)), 수만 개의 셀 문자열 메모리를 밀어내는 과정에서 $O(N)$ 메모리 이동과 힙 단편화가 폭증했습니다.
이번 [4부]에서는 이 두 화면의 UI 스레드 부하를 근본적으로 걷어낸 화면 전용 워커(ScreenWorker), 64MB 스트림 링버퍼 기반 가상 그리드(VirtualGrid), 그리고 무잠금 적응형 쓰로틀링(RefreshPolicy)을 소개합니다.
1. 화면 전용 워커(ScreenWorker)와 28개 필드 백그라운드 사전 포맷팅
관심종목 그리드가 스냅샷 숫자를 읽어서 화면에 찍기 직전의 형태, 즉 "천 단위 콤마가 찍힌 문자열 + 부호 기호(▲/▼) + 텍스트 색상"까지 아예 백그라운드 스레드에서 미리 다 만들어 두면 어떨까요?
우리는 무거운 그리드 화면마다 전담 백그라운드 컨텍스트(ScreenContext)를 부여하고, 다음 두 가지 핵심 기법을 결합했습니다.
flowchart LR
    subgraph Shard["Shard Worker"]
        A["SymbolSnapshot 갱신 완료"] --> B["구독 중인 화면에 ScreenTask 전달"]
    end
    subgraph Screen["ScreenWorker (백그라운드)"]
        B --> C["종목별 Coalescing (중복 틱 병합)"]
        C --> D["28개 표시 필드 천단위 포맷팅 & 등락 색상 사전 연산"]
        D --> E["PreformattedScreenSnap 게시 & DirtySet에 종목코드 추가"]
    end
    subgraph UI["메인 UI 스레드 (OnTimer)"]
        E -->|"PopDirtyCodes()"| F["변경된 종목만 O(1) 조회 후 셀에 문자열 즉시 대입"]
    end
① 큐 레벨 & 더티 셋 레벨 이중 코얼레싱 (Double Coalescing)
장 시작 시 삼성전자 한 종목에 50ms 동안 30번의 체결 패킷이 쏟아졌다고 가정해 봅시다.
ScreenWorker는 큐에 이미 삼성전자 작업이 대기 중이면 새 작업을 중복 삽입하지 않고 최신 스냅샷 포인터만 교체(Task Conflation)합니다.- 설령
ScreenWorker가 50ms 동안 3번 깨어나 포맷팅을 수행했더라도, UI가 읽어가는dirtyCodes집합(unordered_set+vector)에는"005930"이 단 1번만 등록(Dirty Coalescing)됩니다. - 실제 개장 피크 9분간 계측 결과,
ScreenWorker에 유입된 작업 중 53.5%가 더티 코얼레싱 단계에서 병합되어 UI 그리드 갱신 횟수를 절반 이하로 줄였습니다.
② 28개 표시 필드의 Zero-Allocation 사전 포맷팅
ScreenWorker는 숫자 데이터를 고정 크기 문자 배열(char formattedPrice[24], char formattedRate[16] 등)을 가진 PreformattedScreenSnap 구조체에 미리 포맷팅해 둡니다. 덕분에 메인 UI 스레드의 OnTimer는 무거운 CString::Format이나 부동소수점 나눗셈을 전혀 수행하지 않고, 이미 완성된 문자열 버퍼 포인터를 그리드 셀에 그대로 복사하기만 합니다.
2. 초당 수천 건 체결 스트림을 버티는 64MB 가상 그리드 (VirtualGrid & StreamStore)
전 종목 실시간 체결 화면(TimeAndSalesView)은 관심종목 그리드와 성격이 완전히 다릅니다. 종목당 최신 상태 하나만 보여주는 것이 아니라, 매 순간 발생하는 모든 체결 이벤트를 시간순 이력(History)으로 최대 100,000행까지 쌓아두고 스크롤할 수 있어야 합니다.
기존 레거시 그리드는 새 체결이 들어올 때마다:
- 그리드 컨트롤에 실제 행(
Row) 객체를 동적 할당하고, - 12개 컬럼에 해당하는 문자열을 각각 포맷팅해 셀 메모리에 복사했습니다.
10만 행이 쌓이면 셀 객체만 120만 개가 생성되어 메모리 사용량이 치솟고 UI가 급격히 느려졌습니다.
해결책: "보이는 30개 행만 렌더링하고, 원본은 고정 크기 POD 배열에 담아라!"
우리는 체결 1건을 단 40바이트 남짓의 고정 크기 압축 구조체(CompactTradeRow)로 정규화하고, 최대 64MB 상한을 가진 청크형 링버퍼(StreamStore<CompactTradeRow>)에 $O(1)$로 적재하는 가상 그리드(VirtualGrid)를 구현했습니다.
// 체결 1건을 표현하는 40바이트 고정 크기 POD 구조체 (힙 할당 0건!)
struct CompactTradeRow {
    char     code[8];       // 종목코드
    uint32_t timeHhmmss;    // 체결시각 (HHMMSS 정수)
    int64_t  price;         // 체결가격
    int64_t  diff;          // 전일대비 (부호 포함)
    uint64_t tradeVolume;   // 순간 체결수량
    uint64_t cumVolume;     // 누적 거래량 (천주 단위 정규화)
    uint8_t  exchangeKind;  // 거래소 구분 (Primary / ATS / Index)
    uint8_t  signCode;      // 등락 기호 코드 (상한/상승/보합/하락/하한)
};
가상 그리드의 3가지 핵심 메커니즘
- 적재 시점(Ingestion)에는 포맷팅을 전혀 하지 않음 ($O(1)$ Append):
초당 수천 건의 체결이 들어와도StreamStore는 40바이트짜리CompactTradeRow구조체를 연속된 메모리 블록 끝에 복사(Append)하기만 합니다. 문자열 변환이나 힙 할당이 0건입니다. - 렌더링 시점(OnPaint)에는 현재 스크롤 뷰포트의 ~30행만 즉석 포맷팅 (
ReadCell):
아무리 이력이 100,000행 쌓여 있어도 사용자의 모니터에 실제로 보이는 행은 고작 25~35줄입니다.WM_PAINT가 발생할 때 오직 화면에 보이는 행 범위([firstVisibleRow, lastVisibleRow])에 대해서만ReadCell(row, col)을 호출하여 문자열과 색상을 즉석 생성합니다. - 사용자 입력 감지 시 즉시 양보 (
InputPendingBudget Yield):
백그라운드 스트림 큐에서 체결 이벤트를 꺼내StreamStore에 적재하는 루프는 최대2,000us(2ms)예산 또는GetQueueStatus(QS_INPUT)(마우스/키보드 입력 발생) 감지 시 즉시 루프를 멈추고 제어권을 양보합니다. 그 결과 개장 직후 514,918건의 체결 패킷이 쏟아지는 동안에도 UI 입력 양보(inputYields)가 정교하게 작동하며 스크롤과 창 이동이 즉각 반응했습니다.
3. 무잠금 적응형 화면 갱신 쓰로틀러 (RefreshPolicy)
평상시에는 화면을 30ms(약 33fps) 주기로 아주 매끄럽게 갱신하다가도, 개장 직후 1~2초간 순간적으로 백그라운드 큐에 패킷이 몰릴 때는 화면 갱신 주기를 탄력적으로 늦춰(Backpressure) CPU를 패킷 소화에 집중시켜야 합니다.
이를 위해 32비트 원자 변수 단 하나(std::atomic<uint32_t>)에 25비트 타임스탬프 버킷(128ms 단위)과 7비트 권고 주기(5ms 단위)를 비트 패킹하여, 뮤텍스 없이 단일 CAS로 동작하는 적응형 쓰로틀러(RefreshPolicy)를 설계했습니다.
class RefreshPolicy {
    static constexpr uint32_t TickMask = 0x01ffffff;
    mutable std::atomic<uint32_t> state_{0}; // [25-bit timestamp | 7-bit interval/5]

public:
    unsigned Recommend(uint32_t nowMs, size_t pendingTasks) const noexcept {
        // 1. 대기 중인 패킷 수에 따른 목표 갱신 주기(ms) 산출
        const unsigned target =
            pendingTasks >= 120 ? 500 :
            pendingTasks >=  70 ? 300 :
            pendingTasks >=  35 ? 150 :
            pendingTasks >=  15 ?  60 : 30;

        const uint32_t tick = nowMs >> 7; // 128ms 단위 타임 버킷
        uint32_t old = state_.load(std::memory_order_relaxed);
        unsigned current = (old & 127) * 5;
        const uint32_t elapsed = (tick - (old >> 7)) & TickMask;
        const bool forward = elapsed != 0 && elapsed < (TickMask / 2);

        // 2. 부하 증가 시에는 즉시 주기를 올리고(Fast Ramp-Up),
        //    부하 감소 시에는 화면 떨림 방지를 위해 128ms당 25%씩 점진 하향(Smooth Decay)
        if (current == 0 || target > current) {
            current = target;
        } else if (forward && target < current) {
            const unsigned step = (current - target) / 4;
            current -= (step < 5 ? 5 : step);
            if (current < target) current = target;
            current = ((current + 4) / 5) * 5;
        } else if (!forward) {
            return current;
        }

        const uint32_t stamp = (forward || (old & 127) == 0) ? tick : (old >> 7);
        const uint32_t next = (stamp << 7) | (current / 5);
        state_.compare_exchange_strong(old, next, std::memory_order_relaxed);
        return current;
    }
};- Fast Ramp-Up / Smooth Decay: 패킷 적체가 감지되면 지체 없이 주기를 상향하여 UI 스레드를 보호하고, 폭주가 지나가면 계단식으로 부드럽게
30ms까지 회복합니다.
다음 이야기 예고
1차 아키텍처 도입 후 UI 프리징은 극적으로 사라졌습니다. 하지만 우리는 거기서 멈추지 않고 개장 피크 프로파일러 로그를 현미경처럼 다시 들여다보았습니다. 그랬더니 예상치 못한 세 가지 숨은 복병이 모습을 드러냈습니다:
- "왜 UI 프리징은 사라졌는데 프로세스 전체 CPU 점유율은 0.9%에서 1.8%로 올라갔을까?" (범인은 초당 423건씩 날아가던
WM_ENGINE_NOTIFY윈도우 메시지!) - "왜 통합 호가창(
OrderBookView)은 간헐적으로 1틱 그리기에 31ms나 걸릴까?" (범인은 ActiveXVSFlexGrid의put_CellCOM 호출!) - "왜 60종목 멀티 시세판(
MultiQuoteMatrix)만 개장 때 호가가 1초에 한 번씩 끊겨서 바뀔까?" (범인은 코디네이터의 4슬롯 제한과 자가 당착적pressure페널티!)
다음 [5부]에서는 이 세 가지 실전 병목을 완벽히 제압한 극한의 마이크로 최적화 & 트러블슈팅 스토리를 공개합니다.