들어가는 글: "프리징은 잡았지만, 아직 끝난 게 아니다"
1차 아키텍처 적용 후 개장 9분간의 실측 로그(TO-BE)를 분석했을 때, 메인 스레드의 최대 프리징 시간은 1,531ms → 15ms로 사라졌습니다. 하지만 프로파일러의 세부 지표를 뜯어보던 우리는 세 가지 흥미로운 현상을 발견했습니다.
- 현상 ① (윈도우 메시지 스톰):
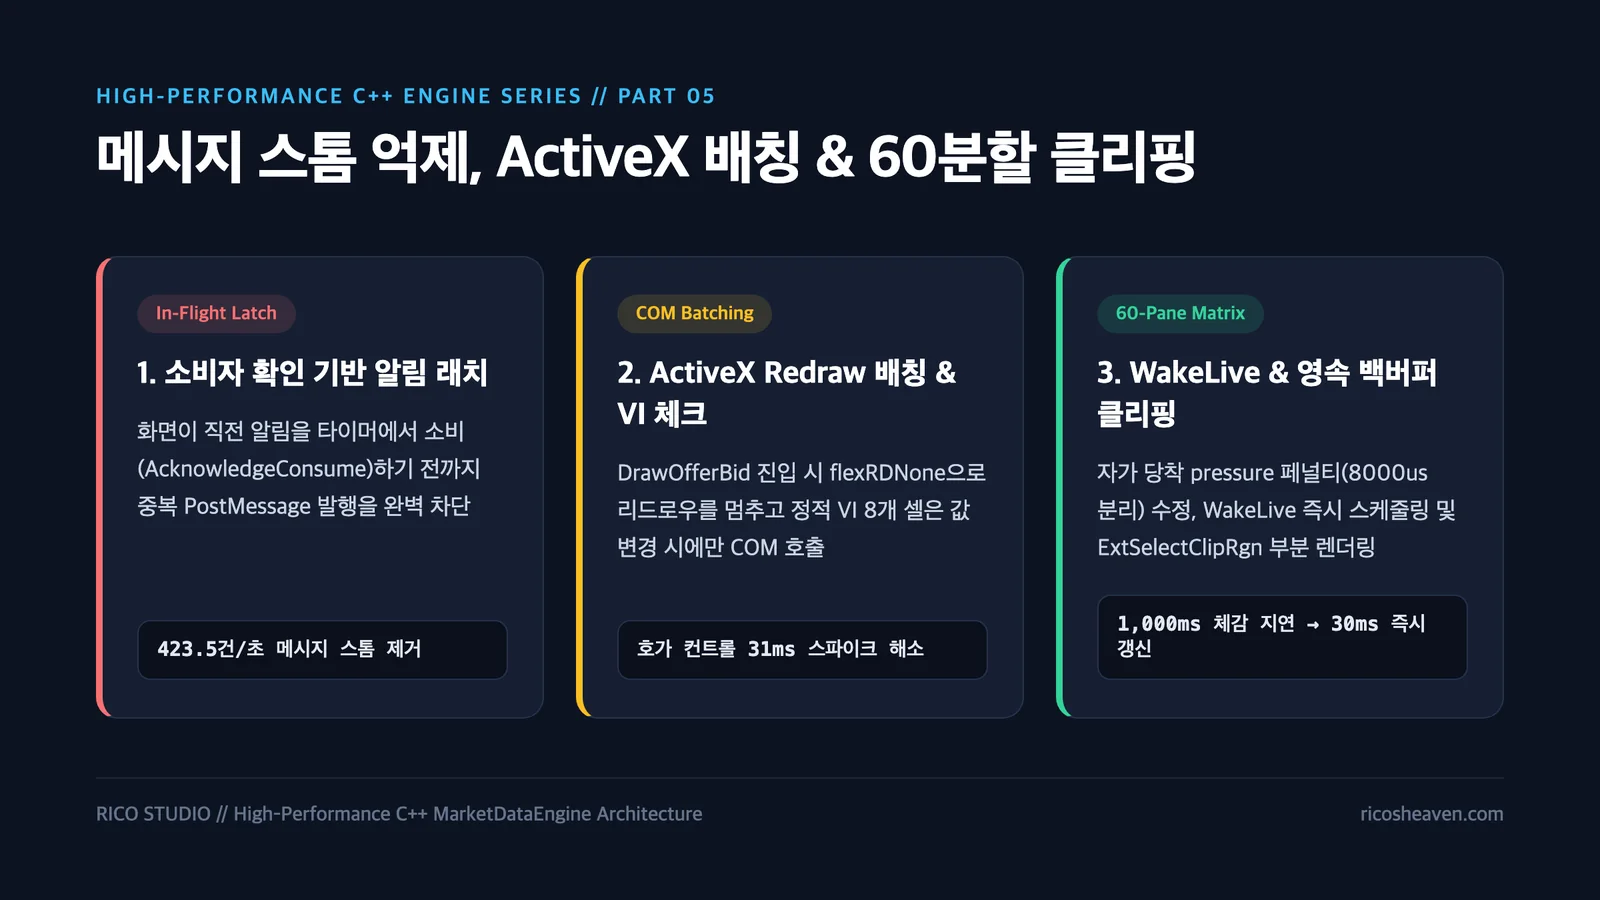
화면은 타이머(50~100ms) 주기로 스냅샷을 풀링(Pull)해 그리는데, 정작 백그라운드 라우터는 540초 동안228,687건(초당 423.5건)의PostMessage(WM_ENGINE_NOTIFY)를 창들에 쏘아대고 있었습니다. - 현상 ② (공통 호가 컨트롤의 31ms 스파이크):
공유 호가 파이프라인을 적용했음에도 호가창 그리드(SharedOrderBookControl)의 1회 렌더링 최대 시간이 간헐적으로31ms까지 튀었습니다. - 현상 ③ (60분할 멀티 시세판의 1초 지연 체감):
관심종목과 호가창은 빛처럼 빠르게 움직이는데, 유독 60개 종목을 바둑판처럼 띄워놓은 멀티 시세판(MultiQuoteMatrix)만 개장 때 호가가 약 1초(750~1,000ms)에 한 번씩 둔하게 바뀌는 현상이 관찰되었습니다.
이번 [5부]에서는 이 세 가지 실전 문제를 어떻게 추적하고 해결했는지 그 생생한 디버깅 과정을 공유합니다.
1. 트러블슈팅 ①: In-Flight Latch로 초당 423건의 윈도우 메시지 스톰 잠재우기
원인 분석
초기 설계에서는 WM_ENGINE_NOTIFY 메시지가 너무 자주 가는 것을 막기 위해 HWND당 50ms 시간 기반 쓰로틀링(kThrottleIntervalMs = 50)을 걸어두었습니다. 하지만 화면에 열린 창(HWND)이 60~70개에 달하면 어떻게 될까요?
- 각 창마다 50ms(초당 20회)씩만
PostMessage를 보내도, 70개 창 $\times$ 초당 20회 = 초당 최대 1,400회의 커널PostMessage가 발생합니다! - 더군다나 각 창은
OnEngineNotify메시지 핸들러에서 단지m_isDirty = true;불리언 플래그 하나만 켜고, 실제 렌더링은 화면 타이머(OnTimer)가 돌 때 수행합니다. - 즉, 화면이 아직 타이머에서
m_isDirty를 소비(Consume)하지도 않았는데, 50ms가 지났다는 이유만으로 똑같은m_isDirty = true를 세팅하기 위해 또PostMessage를 보내고 있었던 것입니다!
해결책: 소비자 확인 기반 In-Flight Latch (PendingNotificationState)
우리는 단순 시간 쓰로틀링을 넘어, "화면이 이전 알림을 소비(AcknowledgeConsume)하기 전까지는 추가 PostMessage를 절대 보내지 않는" 원자적 In-Flight Latch를 설계했습니다.
struct PendingNotificationState {
    static constexpr DWORD kThrottleIntervalMs = 50;
    static constexpr DWORD kMaxInFlightHoldMs  = 250; // 비가시/모달 창 안전 폴백 타임아웃

    std::atomic<bool>  pending{false};
    std::atomic<bool>  inFlight{false};
    std::atomic<DWORD> lastPostTick{0};

    // 화면이 타이머에서 실제로 스냅샷을 소비했을 때 호출!
    void AcknowledgeConsume() noexcept {
        inFlight.store(false, std::memory_order_release);
    }

    bool TryAcquirePostSlot(DWORD nowTick) noexcept {
        // 1. 아직 화면이 직전 알림을 소비하지 않았다면(inFlight == true),
        //    안전 타임아웃(250ms) 전까지는 PostMessage 발행을 즉시 생략!
        if (inFlight.load(std::memory_order_acquire)) {
            const DWORD last = lastPostTick.load(std::memory_order_relaxed);
            if (static_cast<DWORD>(nowTick - last) < kMaxInFlightHoldMs) {
                return false; // 중복 커널 메시지 완벽 차단
            }
        }
        // 2. 최소 50ms 간격 보장 + CAS로 단일 발행권 획득
        // ...
        inFlight.store(true, std::memory_order_release);
        return true;
    }
};
여기에 더해 두 가지 마이크로 최적화를 함께 적용했습니다:
- 구독 등록 시 $O(\log N)$ 조회: 구독 라우터(
SubscriptionRouter::SetAt)가 기존 알림 상태 객체를 찾을 때 전체 토픽 맵을 이중 루프로 순회하던 $O(N_{\text{topics}} \times N_{\text{items}})$ 스캔을m_mapCookieNotifyState단일 조회로 교체했습니다. DispatchToScreens사전 필터링 & 조건부SetEvent: 화면이 구독하지 않는 거래소 패킷은 워커 큐 잠금 전에 즉시 버리고, 워커 큐가 비어 있다가 첫 아이템이 들어올 때(needWake)만 커널 이벤트(SetEvent)를 호출하도록 개선했습니다.
2. 트러블슈팅 ②: ActiveX 호가 그리드 put_Redraw(flexRDNone) 배칭과 VI Dirty-Check
원인 분석
레거시 트레이딩 화면의 상당수는 호가 테이블 렌더링에 상용 COM/ActiveX 그리드 컨트롤(VSFlexGrid 계열)을 사용합니다. 호가창(SharedOrderBookControl::DrawOfferBid)이 한 번 갱신될 때, 10단계 매도/매수 가격·잔량·대비 등 변경된 셀을 업데이트하기 위해 약 40~100번의 put_Cell(...) COM 인터페이스 호출이 일어납니다.
- 문제는 그리드의
Redraw속성이 켜진 상태에서put_Cell을 호출하면, 매 셀을 수정할 때마다 ActiveX 컨트롤 내부에서 셀 범위 계산과 부분 무효화 로직이 40~100번 반복 실행된다는 점이었습니다. - 또한 하루 종일 거의 변하지 않는 정적 VI(변동성완화장치) 기준가/상승·하락 발동가 8개 셀을 이전 프레임 값과 비교하지 않고 매 호가 틱마다
put_Cell로 덮어쓰고 있었습니다.
해결책: RAII Redraw Batch Guard + 정적 셀 Dirty-Check 복원
// 1. DrawOfferBid 진입 시 ActiveX 내부 리드로우를 일시 정지(flexRDNone)하고,
//    모든 셀의 put_Cell 완료 후 단 한 번만 리드로우를 복원하는 가드
long prevRedraw = VSFlex8N::flexRDDirect;
const bool batchRedraw = m_bookPilot.Active();
if (batchRedraw) {
    prevRedraw = m_pGrid->GetRedraw();
    if (prevRedraw != VSFlex8N::flexRDNone) {
        m_pGrid->put_Redraw(VSFlex8N::flexRDNone);
    }
}

// ... (변경된 호가 셀들에 대한 put_Cell 일괄 수행) ...

// 2. 정적 VI 데이터는 이전 틱(m_prevHogaData)과 실제로 달라졌을 때만 COM 호출 수행
const bool bViChanged = m_bForceRepaint ||
    (m_currHogaData.viBasePrice != m_prevHogaData.viBasePrice) ||
    (m_currHogaData.viUpPrice   != m_prevHogaData.viUpPrice)   ||
    (m_currHogaData.viDownPrice != m_prevHogaData.viDownPrice);
if (bViChanged) {
    UpdateStaticViCells();
}

// 3. 종료 시 Redraw 복원 (단 1회 화면 갱신 발생)
if (batchRedraw && prevRedraw != VSFlex8N::flexRDNone) {
    m_pGrid->put_Redraw(prevRedraw);
}
이 간단한 두 줄의 배칭 가드와 VI Dirty-Check만으로 호가창 1회 그리기 시 발생하던 수십 번의 불필요한 COM 레이아웃 연산이 완전히 사라졌습니다.
3. 트러블슈팅 ③: 60분할 멀티 시세판의 "1초 호가 지연" 미스터리 해결
가장 극적이었던 트러블슈팅은 60개 종목을 한 화면에 띄워놓는 멀티 종목 시세판(MultiQuoteMatrix)이었습니다. 장 시작 때 모니터링을 해보면 다른 화면은 실시간으로 빠르게 움직이는데, 유독 이 화면의 호가만 딱 1초에 한 번씩 툭, 툭 끊기며 갱신되는 현상이 있었습니다.
코드를 역추적한 결과, 4가지 원인이 연쇄 작용하여 정확히 750ms ~ 1,000ms의 주기를 만들고 있었던 것을 밝혀냈습니다!
flowchart TD
    A["원인 1: 50ms 타이머당 최대 4개 창만 순회 (60개 / 4 * 50ms = 750ms 대기열)"] --> E["체감 결과: 호가가 1초에 한 번씩만 갱신됨!"]
    B["원인 2: 4ms 예산 사용 시마다 Observe(tickUs >= 4000)가 자가 당착적으로 pressure +50ms씩 최대 +700ms 가산"] --> E
    C["원인 3: 마우스 포커스가 다른 창에 있으면 active=false(기본 300ms) → 300ms + 700ms = 1,000ms 캡핑!"] --> E
    D["원인 4: 시세 변경 없는 빈 폴링(Empty Poll)도 m_lastLiveRefresh 쿨다운을 리셋 + 실시간 틱 도착 시 WakeLive 미호출"] --> E
4중 복합 원인과 해결책
- 자가 당착적
pressure페널티 버그 수정:
프레임 예산 코디네이터(FrameBudgetCoordinator::Run)의 루프 탈출 조건은if (Micros() - start >= 4000) break;(즉, 4ms 예산을 다 쓰면 정상 종료)였습니다. 그런데 루프 직후policy_.Observe(tickUs >= 4000)코드가 "이번 회차가 4,000us 이상 걸렸으니 과부하 상태다!"라고 판정하여pressure페널티를+50ms씩 최대+700ms까지 올리고 있었습니다! 즉, 코디네이터가 정상적으로 4ms 예산을 채워 일할수록 스스로에게 벌점을 주어 갱신 주기를 1,000ms(1초)로 늘려버린 것입니다.
해결: 정상 루프 종료 경계(4,000us)와 실제 단일 콜백 지연 임계값(8,000us)을 분리하여Observe(tickUs >= 8000)으로 수정했습니다. - 50ms당 4개 슬롯 하드코딩 해제 +
WakeLive도입:
실시간 단계(phase == 1)의 슬롯 상한을4개에서max(16, children.size())(최대 60개 전체)로 확장하고 타이머 주기를30ms로 단축했습니다. 또한 실시간 호가/체결 알림(OnEngineNotify) 도착 시 즉시WakeLive(hwnd, due)를 호출해, 먼 미래의due시각을 기다리지 않고 다음 30ms 틱에 바로 갱신되도록 만들었습니다. 마우스 포커스가 옆 창(관심종목 등)에 있더라도 화면에 보이고 있는(!hidden) 창은active = true(기본 주기100ms)로 유지하도록 개선했습니다. - 빈 폴링(Empty Poll) 쿨다운 리셋 버그 및 비관심 도메인
inFlight해제:
시세 변경이 없는 창을 확인만 했을 때는m_lastLiveRefresh타임스탬프를 갱신하지 않도록 고쳐, 5ms 뒤에 도착한 진짜 호가 패킷이 억울하게 쿨다운에 걸리지 않도록 했습니다. 또한 공유 스냅샷의 비관심 도메인(프로그램 매매 등) 패킷 때문에 깨어났을 때도NotifyScreenConsumed를 즉시 호출하여inFlight래치가 250ms 동안 묶이는 현상을 차단했습니다. - 체결 단독 틱(
Trade-Only) 영속 백버퍼 클리핑 (ExtSelectClipRgn):
60개 창이 매번 10호가 전체를 다시 그리면 GDI 비용이 큽니다. 호가는 그대로이고 체결가/거래량만 바뀐 틱(tradeOnly)에서는 상단 종목/현재가/미니봉 영역(m_rectManju | m_rectCurrent | m_rectGrp)만 부분 무효화(InvalidateRect)하고, 영속 오프스크린 비트맵(m_paintBitmap)에::ExtSelectClipRgn(..., RGN_AND)클리핑을 걸어 20줄의 호가 테이블 드로잉(DrawMedo,DrawMesu)을 통째로 생략했습니다!
다음 이야기 예고 (최종회)
이제 모든 퍼즐 조각이 맞춰졌습니다. 과연 이 모든 아키텍처 개선을 거친 뒤, 실제 장 시작 피크 구간의 성능 지표는 어떻게 달라졌을까요? 그리고 수십 년 된 운영 시스템에 이 거대한 변화를 어떻게 단 한 번의 장애도 없이 안전하게 롤아웃(Dual-Path Architecture)할 수 있었을까요?
마지막 [6부]에서는 장 시작 실전 성적표(AS-IS vs TO-BE 정량 비교)와 무중단 A/B 전환 전략 및 프로젝트 회고로 시리즈를 마무리합니다.