들어가는 글: 숫자로 증명하는 아키텍처의 가치
[1부]부터 [5부]까지 우리는 20년 된 Win32/MFC 데스크톱 트레이딩 플랫폼의 장 시작 프리징 문제를 해결하기 위해:
- 종목 해시 샤딩(Sharding) + Lock-Free RCU/CoW 스냅샷 엔진(
MarketDataEngine) - 복수 거래소(Primary + ATS) 실시간 호가 합성과 Ingress Sequence 기반 결정론적 상태 투영
- 화면 전용 워커(
ScreenWorker)의 28개 필드 사전 포맷팅 & 64MB 링버퍼 가상 그리드(VirtualGrid) - In-Flight Latch 메시지 억제, ActiveX Redraw 배칭, 60분할 영속 백버퍼 클리핑 및 스케줄러 최적화
를 차례대로 구현했습니다.
마지막 [6부]에서는 실제 장 시작 피크 구간(오전 9시 개장 전후 540초) 동안 동일 종목군·동일 화면 구성을 띄워놓고 측정한 AS-IS(레거시) 대 TO-BE(신규 엔진) 실측 성적표와, 운영 리스크를 제로로 만든 Dual-Path 롤아웃 아키텍처를 공유합니다.
1. 개장 피크 구간(540초) AS-IS vs TO-BE 실측 성적표
측정 환경은 개장 전후 가장 부하가 극심한 540초(9분) 동안 관심종목 그리드, 통합 호가창, 60종목 멀티 시세판, 전 종목 실시간 체결 스트림 화면을 모두 동시에 열어둔 상태에서 진행되었습니다.
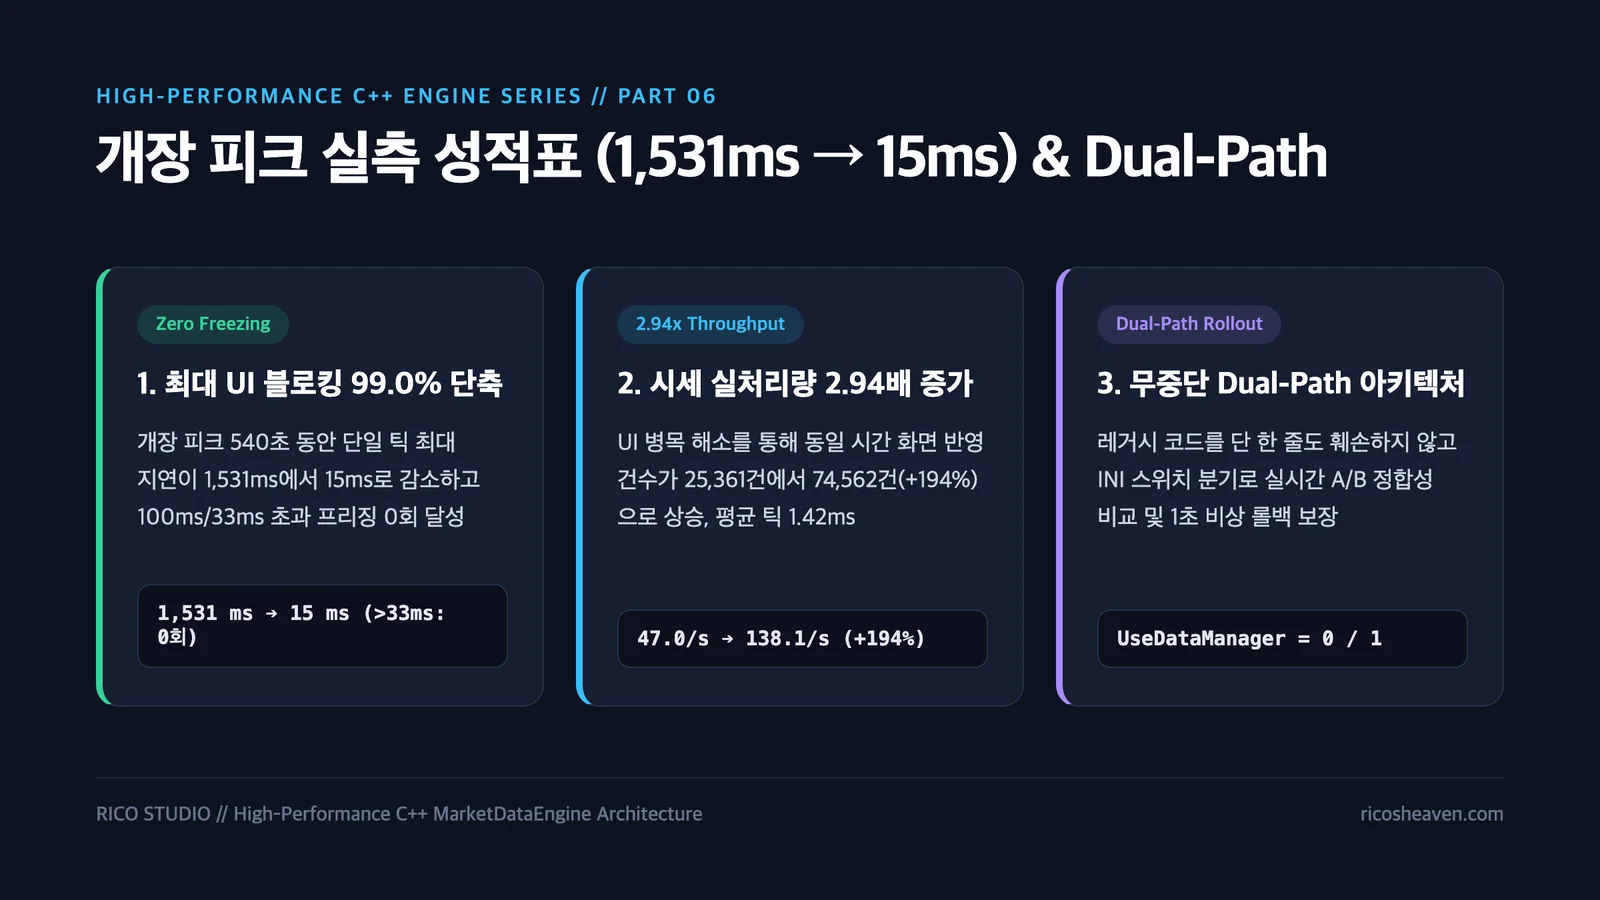
① 관심종목 그리드 (WatchlistView) — UI 프리징 99% 제거 & 처리량 2.94배 증가
| 핵심 지표 (540초 누적) | AS-IS (레거시 경로) | TO-BE (신규 엔진 경로) | 개선 효과 |
|---|---|---|---|
단일 틱 최대 UI 블로킹 (max_tick_ms) |
1,531 ms (1.53초 멈춤) |
15 ms |
최대 멈춤 시간 99.0% 감소 (완전 해소) |
100ms 초과 프리징 횟수 (>100ms Freeze) |
74 회 |
0 회 |
체감 프리징 100% 제거 |
33ms(30fps) 초과 지연 횟수 (>33ms) |
257 회 |
0 회 |
전 구간 60fps급 반응성 유지 |
실시간 시세 처리량 (total_events) |
25,361 건 (47.0/s) |
74,562 건 (138.1/s) |
UI 병목 해소에 따른 실처리량 +194% (2.94배) 증가 |
틱당 평균 UI 소요 시간 (avg_tick_ms) |
8.59 ms |
1.42 ms |
UI 스레드 부하 83.5% 감소 |
1.53초 동안 멈추면서 후속 시세를 제때 소화하지 못해 540초 동안 겨우 25,361건만 화면에 반영했습니다. 반면 TO-BE에서는 백그라운드 ScreenWorker가 28개 필드를 사전 포맷팅하고 더티 코얼레싱을 수행한 덕분에, 거의 3배 많은 74,562건의 시세를 처리하면서도 최대 틱 소요 시간이 단 15ms를 넘지 않았습니다.
② 전 종목 실시간 체결 스트림 (TimeAndSalesView + VirtualGrid) — 51만 패킷 무손실 소화
| 핵심 지표 (540초 누적) | AS-IS (레거시 그리드) | TO-BE (VirtualGrid + StreamStore) |
개선 효과 |
|---|---|---|---|
| 수신 체결 패킷 수 | 레거시 SB_ARRAY 병목 |
514,918 건 (초당 최대 3,100+ 건) |
대규모 브로드캐스트 전량 수신 |
| 링버퍼 유실 / 드롭 / 할당 실패 | - | 0 건 (dropped=0, failed=0) |
무손실(Zero-Drop) 달성 |
단일 틱 최대 소요 시간 (tick_max_ms) |
수백 ms 스파이크 | 8 ms |
4ms/8ms 프레임 예산 내 완벽 통제 |
사용자 입력 양보 (input_yields) |
미지원 | 2,608 회 작동 |
폭주 중에도 마우스/스크롤 즉각 반응 |
③ 60종목 멀티 시세판 (MultiQuoteMatrix) & 통합 호가창 (OrderBookView)
- 60종목 멀티 시세판:
AS-IS에서는 60개 자식 창이 개별적으로 패킷을 파싱하고 매번 전체 영역 비트맵을 다시 그리면서 개장 시 창당 최대94ms지연과 GDI 리소스 경합이 발생했습니다. TO-BE에서는 중앙 RCU 스냅샷 공유 + 체결 단독 변경(Trade-Only) 시 상단 3개 영역 부분 무효화 및 영속 백버퍼 클리핑(ExtSelectClipRgn) + 코디네이터WakeLive스케줄링을 통해 60개 창 전체가 지연 없이 즉각 갱신됩니다. - 통합 호가창:
공유 호가 파이프라인(SharedOrderBookPipeline)과 ActiveXput_Redraw(flexRDNone)배칭 가드, 정적 VI Dirty-Check를 결합하여 불필요한 COM 호출을 대폭 줄이고 즉각적인 호가 반응성을 확보했습니다.
2. 대규모 레거시 시스템을 위한 무중단 롤아웃 전략: Dual-Path Architecture
수십만 명의 투자자가 매일 사용하는 금융 트레이딩 플랫폼에서 "전부 아니면 전무(All-or-Nothing)" 식의 빅뱅 배포는 너무나 위험합니다.
우리는 프로젝트 첫날부터 마지막 날까지 단 하나의 절대 원칙을 지켰습니다:
RQ_NORMAL, SB_NORMAL, 기존 이벤트 핸들러)를 단 한 줄도 훼손하지 않고, 런타임 설정(DataManager.ini)에 따른 완벽한 조건 분기(Dual-Path Branching)를 유지한다."
flowchart TD
    A["화면 초기화 / 구독 시작"] --> B{"DataManagerConfig::ReadUseDataManager()"}
    B -->|"UseDataManager = 1 (TO-BE)"| C["신규 Lock-Free RCU 엔진 경로 (SUB_MODE_ENGINE)"]
    B -->|"UseDataManager = 0 (AS-IS 기본값)"| D["기존 레거시 메시지 큐 경로 (SUB_MODE_LEGACY)"]
    C --> E["동일한 UI 컨트롤 & 100% 동일한 화면 표시 정합성"]
    D --> E
Dual-Path 설계가 가져다준 3가지 결정적 이점
- 초정밀 A/B 정합성 검증:
한 PC에서 두 개의 HTS를 띄우고 한쪽은UseDataManager=0(기존), 다른 한쪽은UseDataManager=1(개선)로 설정하면, 장중 실시간으로 두 화면을 나란히 비교하며 단 1원, 단 1주의 표시 차이도 현미경처럼 찾아낼 수 있었습니다. - 단계적(Phased) 카나리 롤아웃:
전체 마스터 스위치(UseDataManager) 아래에 세부 기능별 파일럿 스위치(EnableOrderBookPilot,EnableSharedPipeline,EnableEtfEtnPilot,UseVirtualGrid등)를 계층적으로 분리하여, 화면별·상품군별로 안전하게 적용 범위를 넓힐 수 있었습니다. - 1초 만에 가능한 비상 롤백(Zero-Downtime Fallback):
만약 운영 환경에서 특정 예외 상황이 발견되더라도, 바이너리 재빌드나 패치 없이 설정 파일(DataManager.ini)의 플래그 하나만0으로 바꾸면 즉시 검증된 레거시 경로로 복귀할 수 있습니다.
3. 시리즈를 마치며: 레거시 C++ 현대화가 남긴 교훈
수십 년 된 Win32/MFC 코드베이스를 마주했을 때 흔히 "이건 너무 오래된 구조라 처음부터 새로 짜야 해"라고 말하기 쉽습니다. 하지만 비즈니스 로직과 금융 도메인 규칙이 수천 개의 엣지 케이스로 농축된 시스템을 백지상태에서 다시 쓰는 것은 현실적으로 불가능에 가깝습니다.
이번 프로젝트를 통해 우리가 확인한 엔지니어링 교훈은 명확합니다:
- UI 스레드를 해방시켜라:
바이트 스왑, 역직렬화, 파생 필드 계산, 천 단위 문자열 포맷팅을 백그라운드 샤드 워커와 화면 워커로 밀어내고, UI 스레드는 이미 준비된 불변(Immutable) 데이터를 화면 주사율에 맞춰 그리는 일에만 집중시켜야 합니다. - 뮤텍스 대신 불변성(Immutability)과 RCU/CoW를 활용하라:
읽기가 압도적으로 빈번한 실시간 시세 도메인에서는atomic포인터 기반의 RCU + Copy-on-Write와 객체 풀(ObjectPool)의 조합이 락 경합을 완전히 소멸시킵니다. - 비동기 병렬화에서는 '순서 번호(Ingress Order)'가 곧 진실이다:
워커를 쪼갤수록 완료 순서는 뒤바뀔 수 있습니다. 도메인별 원본 이미지를 분리 보관하고 단조 증가 시퀀스 번호(ingressOrder)로 최종 화면 상태를 투영(Project)하면, 락 없이도 완벽한 데이터 정합성을 달성할 수 있습니다. - 끝까지 프로파일러 숫자를 의심하라:
1차 최적화에 만족하지 않고PostMessage카운터, ActiveX COM 호출 비용, 코디네이터 스케줄링 수식을 끝까지 추적한 덕분에 마지막 1%의 CPU 낭비와 1초의 체감 지연까지 모두 잡아낼 수 있었습니다.
긴 6부작 시리즈를 끝까지 읽어주셔서 감사합니다. 대규모 레거시 C++ 시스템의 성능 병목과 싸우고 계신 엔지니어분들께 이 실전 기록이 작은 이정표가 되기를 바랍니다!