2026년 8월 23일 일요일, 고빈도 매매(HFT) 금융 시스템, AAA 게임 엔진, 실시간 오디오 신호 처리, 임베디드 커널 드라이버를 개발하는 시스템 엔지니어들에게 "메모리 할당 오버헤드와 레이턴시 지터(Latency Jitter)를 어떻게 0으로 만들 것인가?"는 항상 가장 중요한 화두다.
최근 C++26 표준화 과정에서 가장 주목받는 기술적 변화 중 하나는, 힙 메모리 할당 없이 스택에 동적 크기 벡터를 구성하는 std::inplace_vector<T, N>, CPU 캐시 라인을 극대화하는 std::flat_map / std::flat_set, 그리고 락프리(Lock-Free) 동시성 환경에서 메모리를 안전하게 회수하는 해저드 포인터(Hazard Pointers, P2530)의 표준 채택이다.
이 도구들이 어떻게 기존의 메모리 병목을 해소하고 마이크로초(µs) 이하의 초저지연 성능을 보장하는지 실전 코드와 함께 정리해 본다.
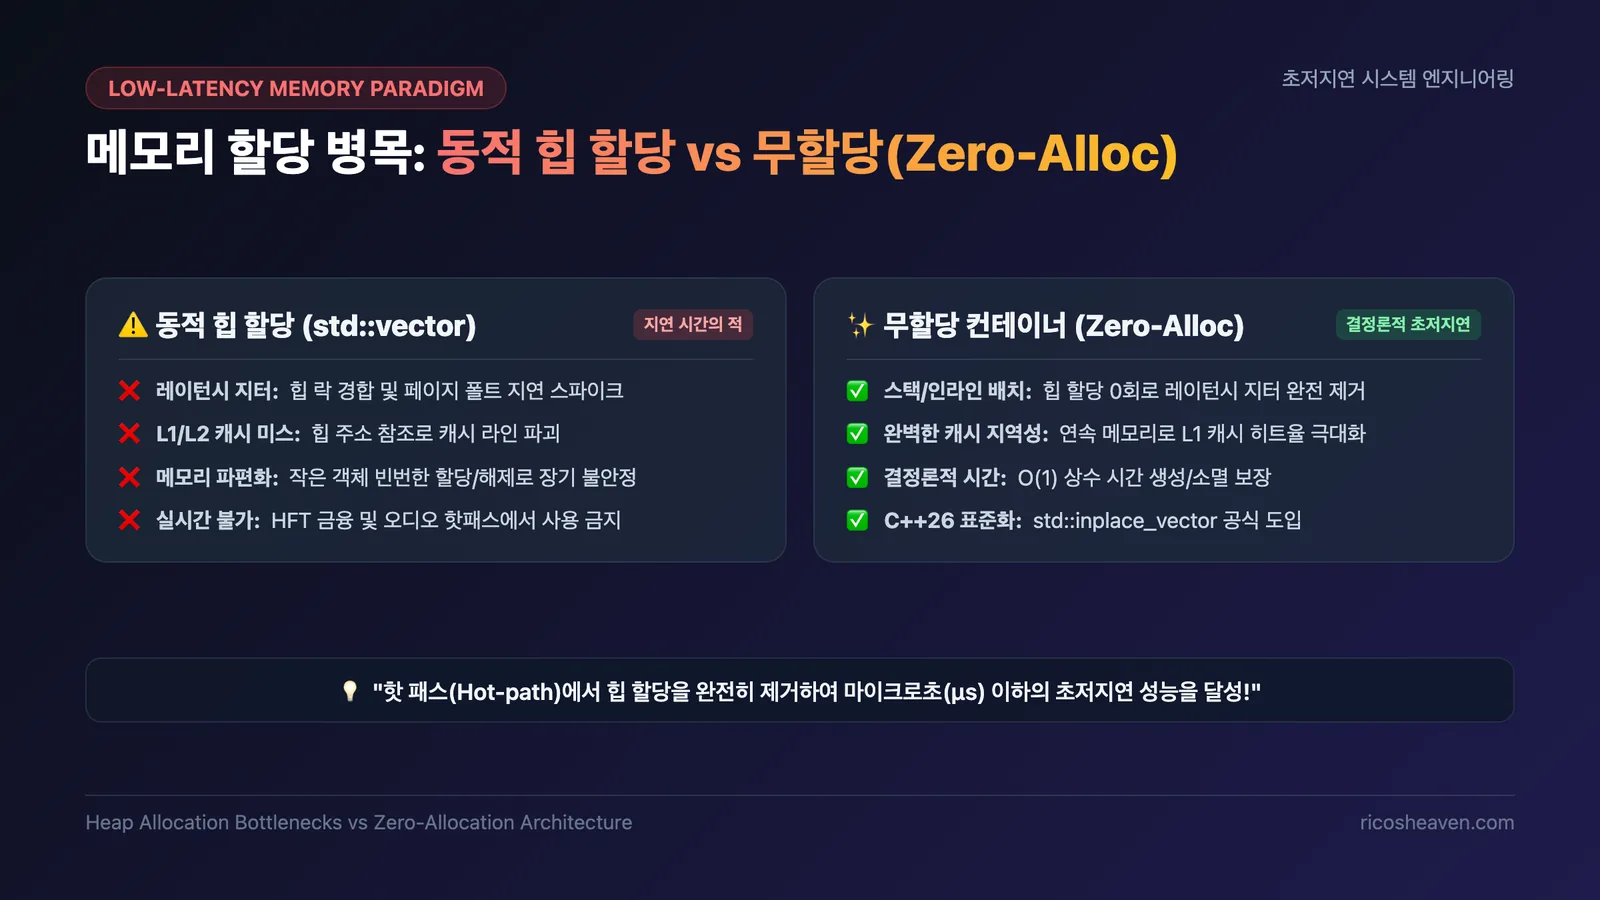
1. 저지연 시스템에서 힙 할당(Heap Allocation)이 치명적인 이유
일반적인 애플리케이션 개발에서는 std::vector나 std::map의 편의성이 뛰어나지만, 수십 나노초(ns) 단위의 결정을 내려야 하는 고성능 시스템에서는 힙 메모리 할당(malloc / operator new)이 치명적인 병목을 일으킨다.
- 비결정적 실행 시간(Non-Deterministic Latency & Jitter): 힙 메모리 관리자 내부의 글로벌 락 경합, 가상 메모리 페이지 폴트(Page Fault), 청크 분할 과정으로 인해 평균 실행 시간은 빨라도 가끔씩 수백 마이크로초의 거대한 지연 스파이크(Jitter)가 발생한다.
- L1/L2 CPU 캐시 미스(Cache Misses): 힙에 파편화된 메모리를 참조할 때마다 CPU 캐시 라인이 비워지고 DRAM에서 데이터를 읽어와야 하므로 수백 클록 사이클이 낭비된다.
- 메모리 파편화(Fragmentation): 작은 객체의 잦은 할당과 해제는 장기 실행 서버의 메모리를 조각내어 시스템 안정성을 해친다.
따라서 고성능 엔지니어링의 황금률은 "핫 패스(Hot-path)에서는 동적 힙 할당을 일체 발생시키지 않는 무할당(Zero-Allocation) 패턴을 적용하는 것"이다.
2. std::inplace_vector<T, N>: 스택 기반 무할당 벡터의 완성
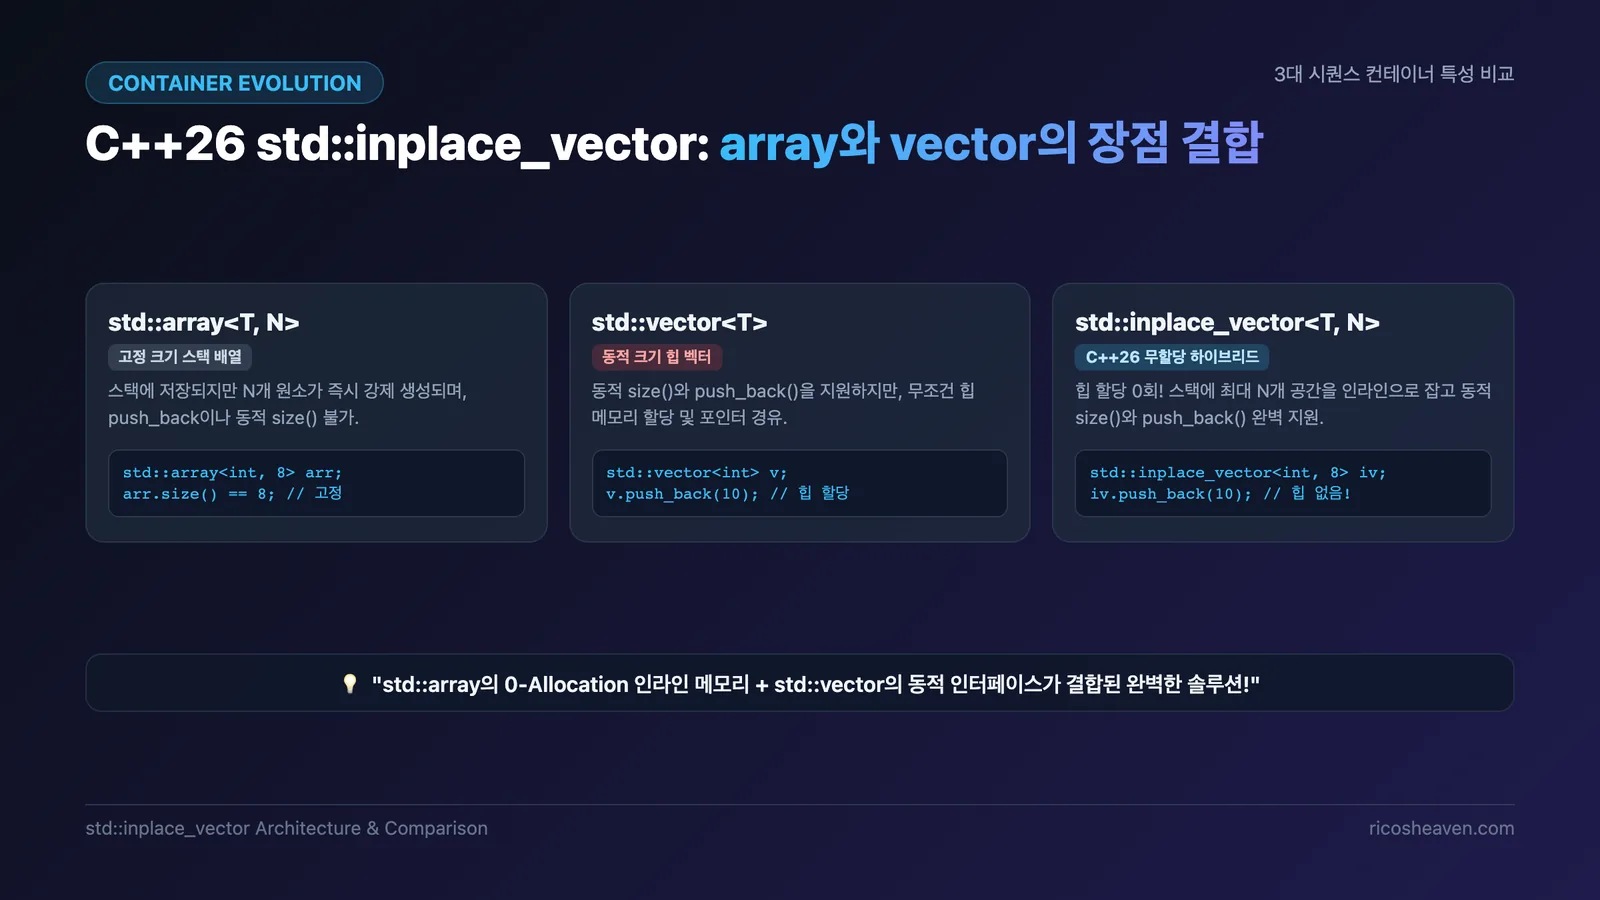
C++26의 std::inplace_vector는 std::array의 인라인 고정 메모리(스택 배치)와 std::vector의 동적 크기 조절 기능을 결합한 완벽한 하이브리드 컨테이너다.
1) 3대 컨테이너 특징 비교
- std::array<T, N>: 스택에 저장되지만 항상
N개의 원소가 즉시 생성되어야 하며,push_back이나 실제 원소 개수(size())를 자체적으로 추적하지 못함. - std::vector<T>: 동적
size()와push_back()을 지원하지만, 힙 메모리를 무조건 할당함. - std::inplace_vector<T, N>: 힙 할당 0(Zero Heap). 최대 용량
N크기의 연속 메모리를 스택 또는 부모 객체 내부에 인라인으로 확보하고, 실제 담긴 원소 개수만 동적으로 관리.
2) 실전 활용 코드 예제
#include <iostream>
#include <inplace_vector>

struct Order {
    int id;
    double price;
    int qty;
};

// 최대 8개의 주문을 힙 할당 없이 스택에서 초고속 처리
void process_batch_orders() {
    std::inplace_vector<Order, 8> orders; // 힙 할당 0회!

    // 1. 일반적인 push_back (용량 초과 시 std::bad_alloc 예외 발생)
    orders.push_back(Order{101, 50000.0, 10});
    orders.push_back(Order{102, 50100.0, 5});

    // 2. 예외 금지 환경을 위한 try_push_back (성공 여부 포인터 반환)
    if (auto* ptr = orders.try_push_back(Order{103, 49900.0, 20})) {
        std::cout << "Order 103 added safely!\n";
    }

    // 3. 극상의 성능을 위한 unchecked_push_back (용량 검사 생략, 초과 시 UB)
    orders.unchecked_push_back(Order{104, 50200.0, 15});

    std::cout << "Total Orders: " << orders.size() << " / " << orders.capacity() << "\n";
}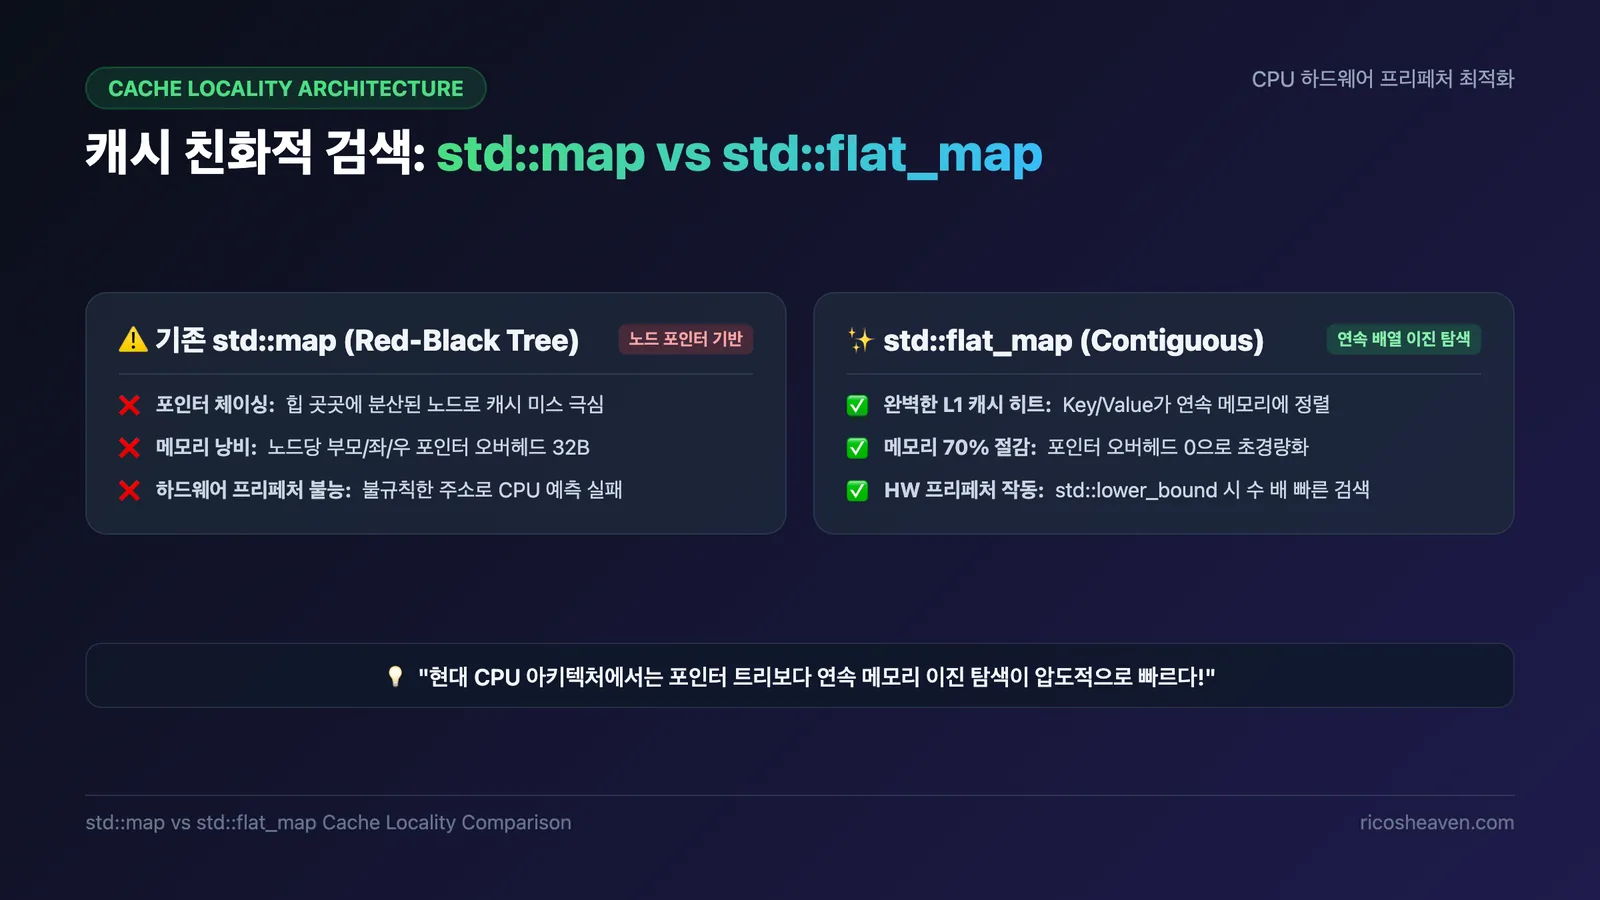
3. 캐시 친화적 연속 컨테이너: std::flat_map & std::flat_set
기존 std::map과 std::set은 노드 기반의 레드-블랙 트리(Red-Black Tree) 구조로 구현되어 있다. 트리의 노드를 탐색할 때마다 포인터를 타고 힙의 전혀 다른 메모리 번지로 점프(Pointer Chasing)해야 하므로 극심한 CPU 캐시 미스가 발생한다.
std::flat_map의 동작 원리
std::flat_map은 Key 배열과 Value 배열을 연속된 1차원 메모리(기본 std::vector 또는 std::inplace_vector)에 정렬된 상태로 보관하는 컨테이너 어댑터다.
- 압도적인 검색 속도: 데이터가 연속 메모리에 밀집되어 있어,
std::lower_bound이진 탐색 시 현대 CPU의 하드웨어 프리페처(Hardware Prefetcher)가 데이터를 L1/L2 캐시로 미리 당겨온다. - 메모리 절약: 각 노드마다 좌/우 자식 포인터, 부모 포인터, 색상 플래그(노드당 24~32바이트)를 유지할 필요가 없어 메모리 사용량이 최대 70% 이상 감소한다.
#include <iostream>
#include <flat_map>
#include <string>

int main() {
    // 내부적으로 연속된 배열을 사용하는 캐시 친화적 정렬 맵
    std::flat_map<int, std::string> user_table;

    user_table[101] = "Alice";
    user_table[205] = "Bob";
    user_table[150] = "Charlie"; // 자동으로 정렬 유지

    // 연속 메모리 이진 탐색으로 초고속 조회
    auto it = user_table.find(150);
    if (it != user_table.end()) {
        std::cout << "Found: " << it->second << "\n";
    }
}
4. 락프리 동시성 메모리 회수: 해저드 포인터 (Hazard Pointers, P2530)
멀티스레드 환경에서 뮤텍스(Mutex)를 쓰지 않고 원자적 연산(std::atomic)만으로 락프리 큐(Lock-Free Queue)나 스킵 리스트를 구현할 때 가장 해결하기 힘든 난제가 바로 "안전한 메모리 회수(Safe Memory Reclamation, SMR)"다.
1) 락프리 환경의 Use-After-Free 딜레마
- 상황: 스레드 A가 락프리 큐의 특정 노드
X를 읽으려고 포인터를 획득한 순간, 스레드 B가X를 큐에서 삭제(Unlink)하고 즉시delete해버림. - 결과: 스레드 A는 이미 해제된 메모리를 참조하게 되어(Use-After-Free) 치명적인 세그멘테이션 폴트나 데이터 오염이 발생함.
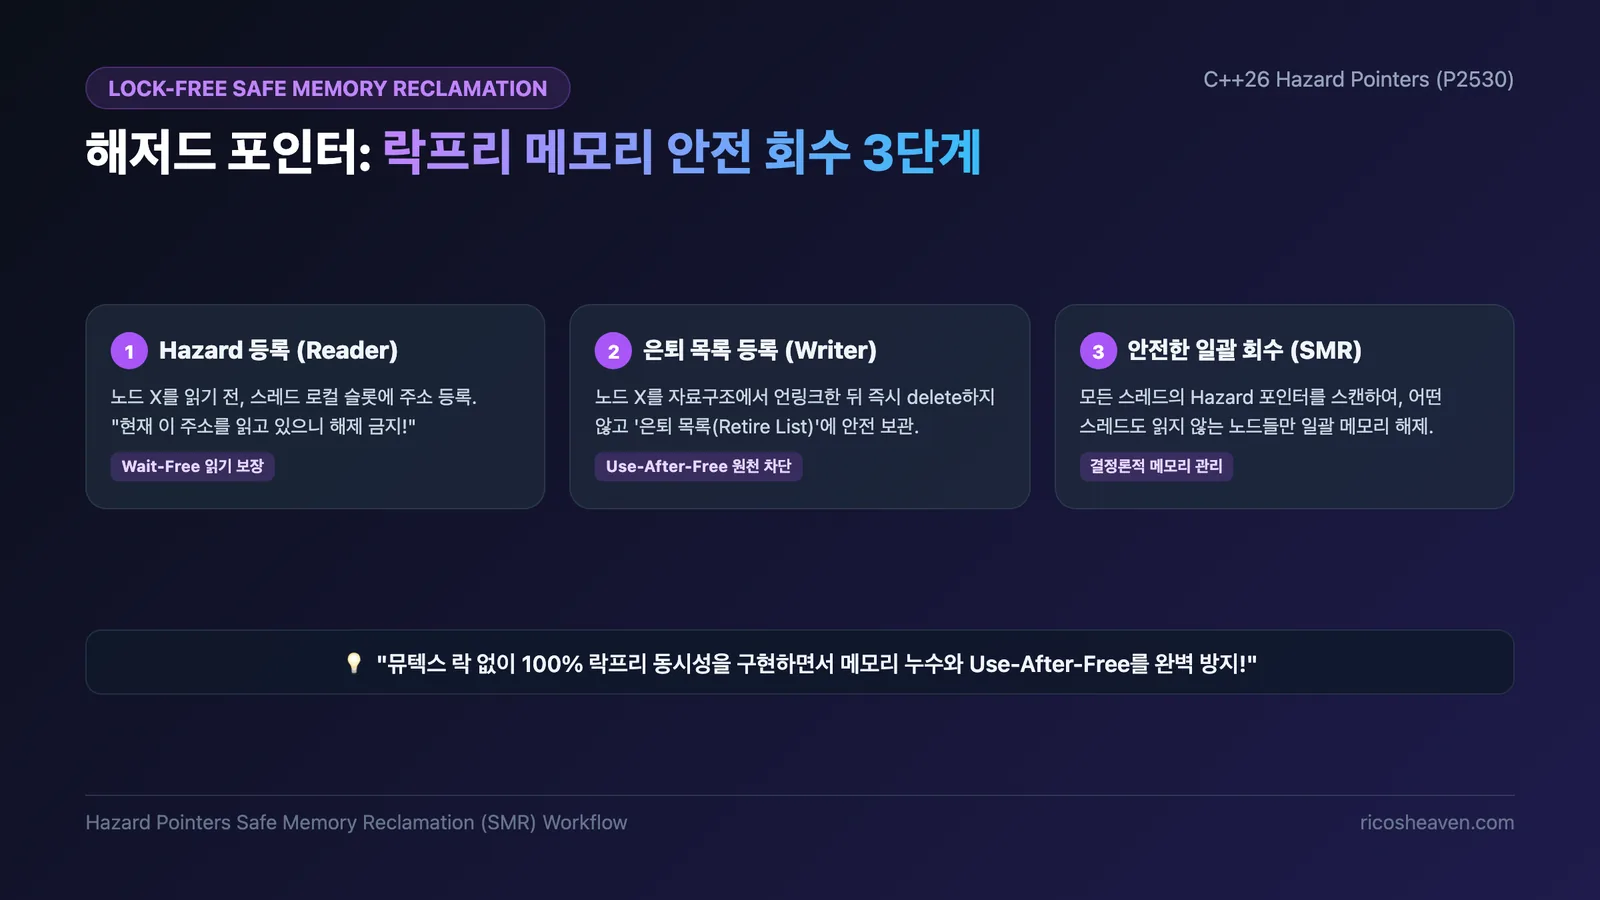
2) std::hazard_pointer의 해법
- 읽기 스레드 (Hazard 선언): 노드
X를 읽기 전, 스레드 로컬 해저드 포인터 슬롯에X의 메모리 주소를 등록한다. ("현재 내가 이 주소를 읽고 있으니 아무도 해제하지 마라!") - 삭제 스레드 (은퇴 목록 등록): 노드
X를 자료구조에서 언링크한 뒤, 즉시delete하지 않고 '은퇴 목록(Retire List)'에 넣는다. - 안전한 일괄 해제 (Reclamation): 은퇴 목록이 일정 크기 이상 쌓이면, 다른 모든 스레드의 해저드 포인터를 검사하여 어떤 스레드도 참조하지 않는 안전한 노드들만 일괄 해제한다.
이 방식을 통해 락(Lock) 없이도 100% 안전한 웨이트프리(Wait-Free) 읽기 패스를 구현할 수 있다.
5. 시스템 엔지니어의 관점 총평
C++26의 고성능 표준 라이브러리 추가는 단순한 유틸리티 확장이 아니다. 저지연·고동시성 시스템의 아키텍처 패러다임을 바꿀 강력한 무기들이다.
- std::inplace_vector: 핫 패스에서 힙 할당을 완벽히 제거하여 레이턴시 지터 0 달성.
- std::flat_map: 포인터 체이싱을 없애고 현대 CPU의 캐시 라인과 하드웨어 프리페처를 극한까지 활용.
- std::hazard_pointer: 락프리 자료구조의 가장 큰 난제였던 메모리 수명 주기를 표준화된 안전한 방식으로 해결.
극강의 성능과 결정론적 지연 시간을 요구하는 금융, 게임, 임베디드, 실시간 백엔드 시스템 개발자라면 C++26의 무할당·락프리 도구들을 적극적으로 도입해 볼 것을 강력히 추천한다.