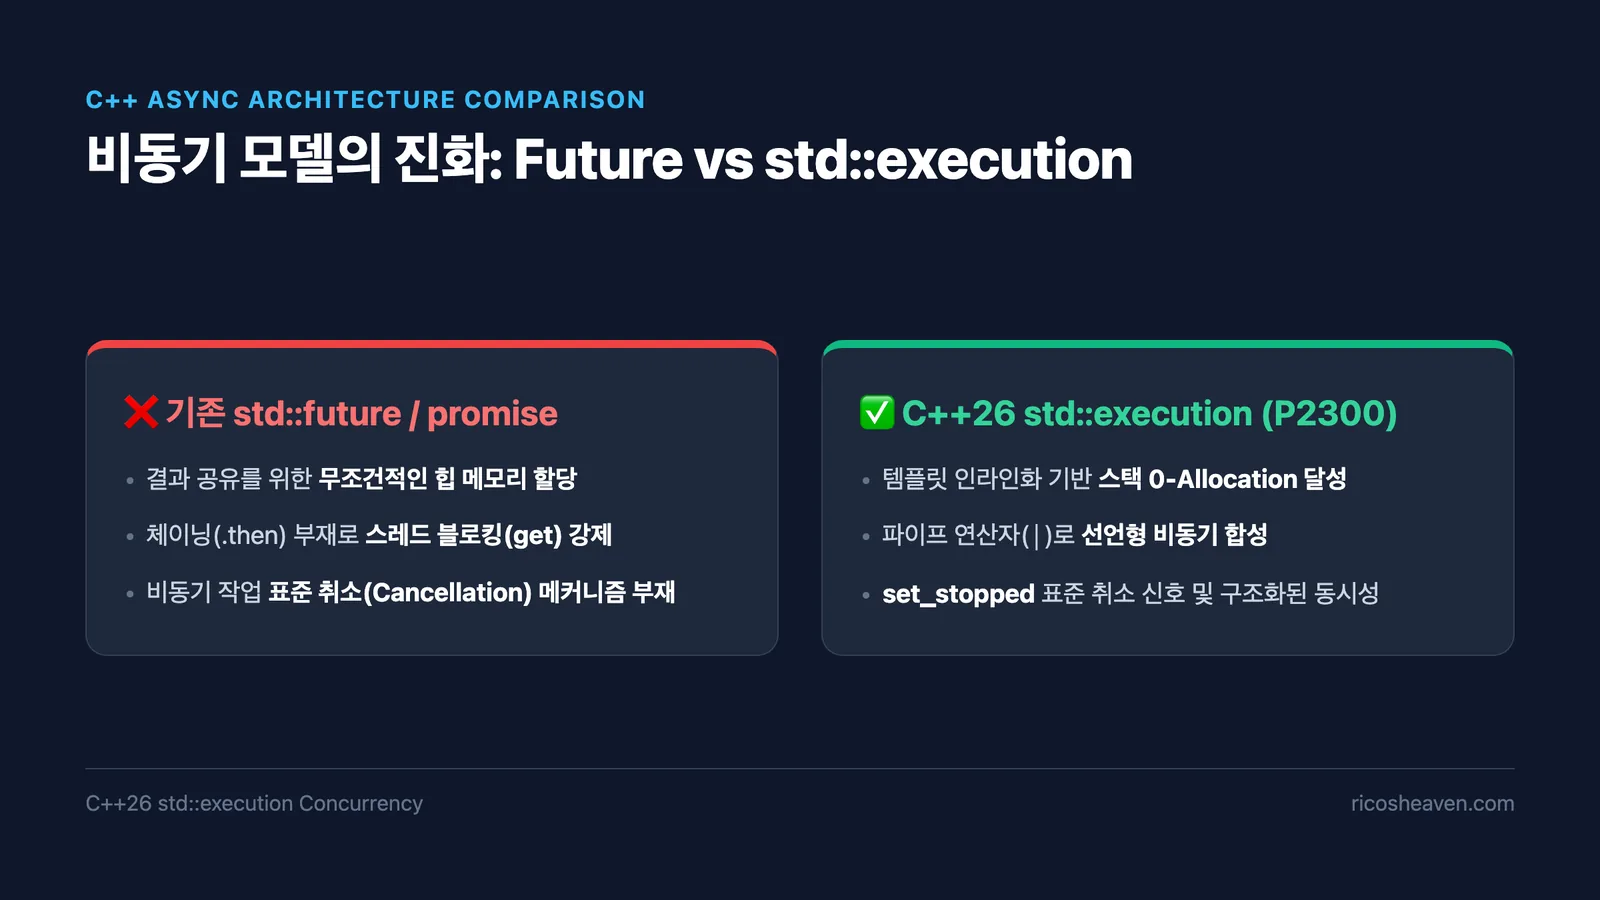
C++에서 비동기 및 병렬 처리는 오랫동안 개발자들을 괴롭혀온 난제였습니다. std::thread, std::future, std::promise는 힙 메모리 할당 강제, 비동기 작업의 합성(Composition) 불가, 스레드 블로킹, 취소(Cancellation) 메커니즘의 부재라는 한계를 안고 있었습니다.
C++26에 공식 도입된 std::execution (P2300: Senders/Receivers 모델)은 이러한 파편화된 비동기 생태계를 완전히 통합하고, 동적 할당 없는(Zero-Allocation) 구조화된 동시성(Structured Concurrency)을 언어 표준으로 제공합니다.
본 글에서는 std::execution의 핵심 3대 개념(Schedulers, Senders, Receivers)과 동작 원리를 살펴보고, 고성능 HTS 및 서버 환경에서 비동기 파이프라인을 구축하는 구체적인 실무 코드 예시를 상세히 분석합니다.
1. 기존 C++ 동시성 모델의 한계와 std::execution의 등장 배경
기존 C++ 표준이 제공하던 비동기 도구들은 현대의 멀티코어·초저지연 시스템 요구사항을 충족하기에 역부족이었습니다:
std::future/std::promise의 병목: 결과를 공유하기 위해 내부적으로 무조건 힙 메모리(Shared State)를 동적 할당하며, 여러 비동기 작업을 이어 붙이는 체이닝(Chaining,.then())이 표준에 없어 스레드가get()에서 블로킹되어야 했습니다.std::async의 결함: 반환된 future의 소멸자가 암묵적으로 블로킹을 유발하여 예측 불가능한 지연을 초래했습니다.- 취소(Cancellation) 지원 부재: 비동기 작업 도중 타임아웃이나 사용자 취소 요청이 발생했을 때 이를 안전하게 중단할 표준적인 경로가 없었습니다.
std::execution은 "작업의 정의(What)"와 "작업의 실행 장소(Where/How)"를 완전히 분리하여, 힙 할당 없이 컴파일 타임에 모든 비동기 작업 그래프를 합성하고 최적화할 수 있도록 설계되었습니다.
2. std::execution의 3대 핵심 추상화: Schedulers, Senders, Receivers
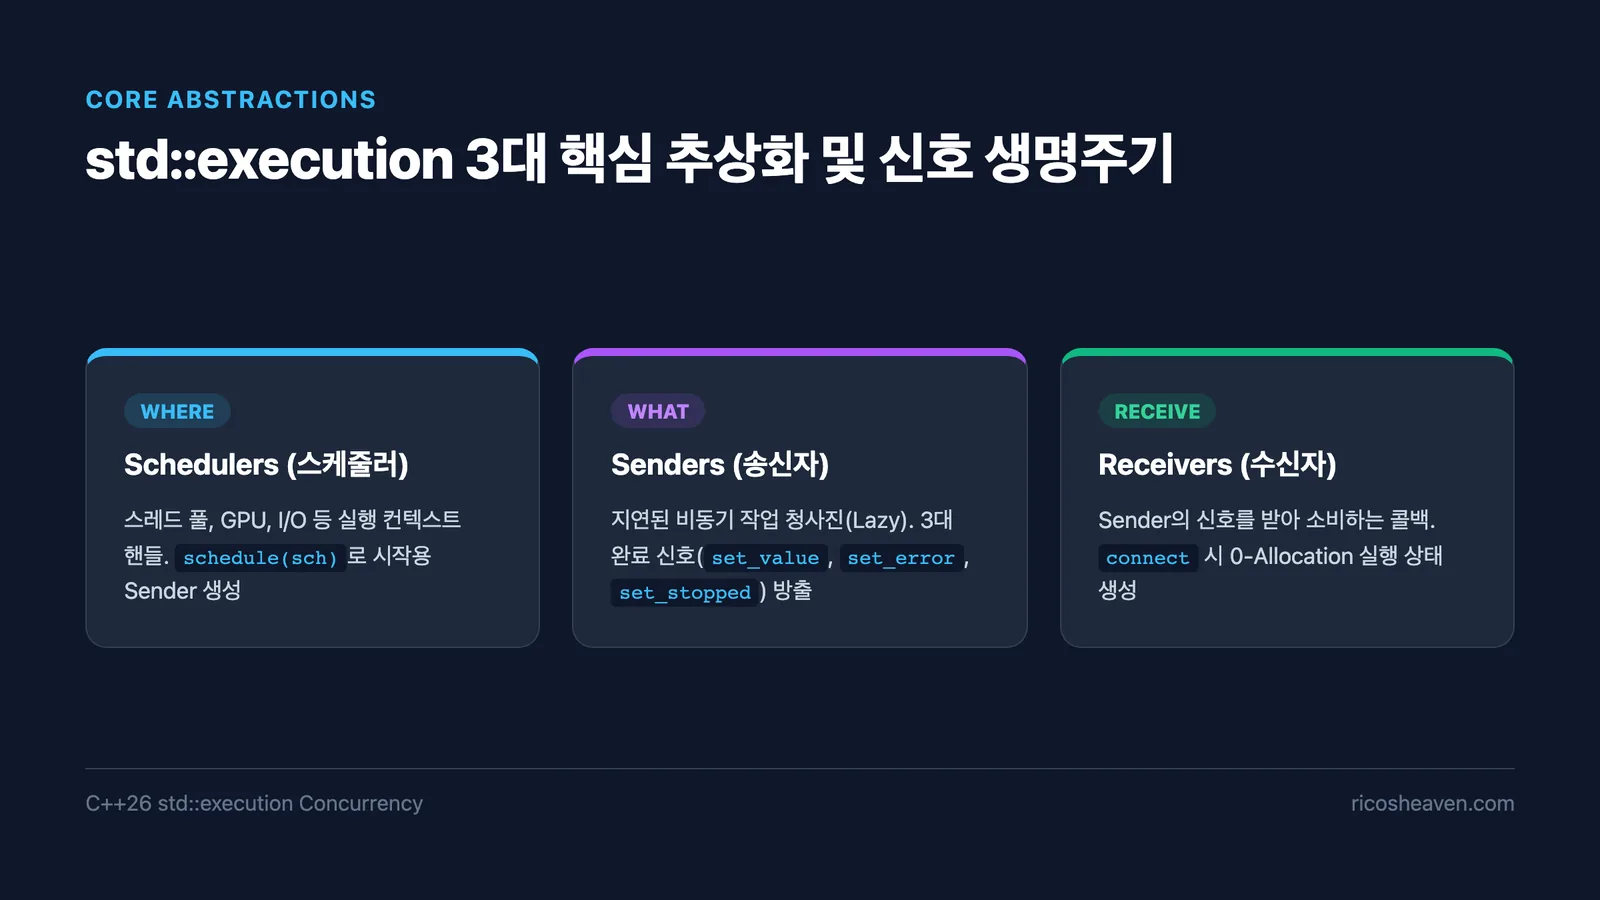
std::execution 모델은 직관적이고 강력한 3가지 핵심 요소로 구성됩니다:
2.1 Schedulers (스케줄러)
- 역할: 작업이 실행될 실행 컨텍스트(스레드 풀, GPU, 이벤트 루프, I/O 스레드 등)를 나타내는 경량 핸들입니다.
- 동작:
std::execution::schedule(sch)함수를 호출하면, 해당 스케줄러 위에서 시작될 준비가 된 Sender를 반환합니다.
2.2 Senders (송신자)
- 역할: 비동기 작업의 '지연된 레시피(Lazy Recipe)'입니다. 즉, 생성 즉시 실행되지 않으며 비동기 연산의 청사진을 기술합니다.
- 3가지 완료 신호(Completion Signals):
set_value(args...): 작업이 정상 완료되어 결과값을 전달set_error(e): 작업 중 예외나 에러가 발생하여 에러를 전달set_stopped(): 작업이 취소되어 안전하게 중단됨
2.3 Receivers (수신자)
- 역할: Sender가 방출한 3가지 신호를 전달받아 소비하는 콜백 인터페이스입니다.
- 개발자가 직접 Receiver를 구현할 일은 거의 없으며, 표준 알고리즘이 내부적으로 Sender와 Receiver를 결합(
connect)하여 실행 상태(operation_state)를 생성합니다.
3. 고성능 비동기 파이프라인 구축 및 핵심 알고리즘
std::execution은 C++20의 파이프 연산자(|)를 지원하여 복잡한 비동기 흐름을 마치 유닉스 파이프라인처럼 선언형으로 합성할 수 있습니다.
3.1 실무 기초 파이프라인 예시: 스레드 전환과 체이닝
I/O 스레드 풀에서 데이터를 수신하고, 계산 스레드 풀로 컨텍스트를 전환(Transfer)하여 가공한 뒤 결과를 동기식으로 수신하는 기본 예제입니다.
#include <execution>
#include <iostream>

namespace ex = std::execution;

void BasicPipelineExample(ex::scheduler auto io_sched, ex::scheduler auto cpu_sched) {
    // 비동기 작업 파이프라인 선언 (아직 실행되지 않는 Lazy Sender)
    auto work = ex::schedule(io_sched)
        // 1. I/O 스케줄러에서 데이터 읽기
        | ex::then([]() {
            std::cout << "[I/O Thread] Raw data received\n";
            return 42; // 원시 데이터 반환
        })
        // 2. CPU 계산 스케줄러(스레드 풀)로 컨텍스트 전환
        | ex::transfer(cpu_sched)
        // 3. CPU 스레드에서 무거운 연산 수행
        | ex::then([](int val) {
            std::cout << "[CPU Thread] Processing heavy computation\n";
            return val * 100;
        })
        // 4. 에러 처리 핸들러 부착
        | ex::upon_error([](std::exception_ptr e) {
            std::cerr << "Error occurred during execution\n";
            return 0;
        });

    // 5. 파이프라인 시작 및 동기 대기 (sync_wait)
    auto result = ex::sync_wait(std::move(work));
    if (result) {
        auto [finalValue] = *result;
        std::cout << "Final Result: " << finalValue << "\n";
    }
}
4. 실전 응용: HTS 실시간 시세 처리 파이프라인
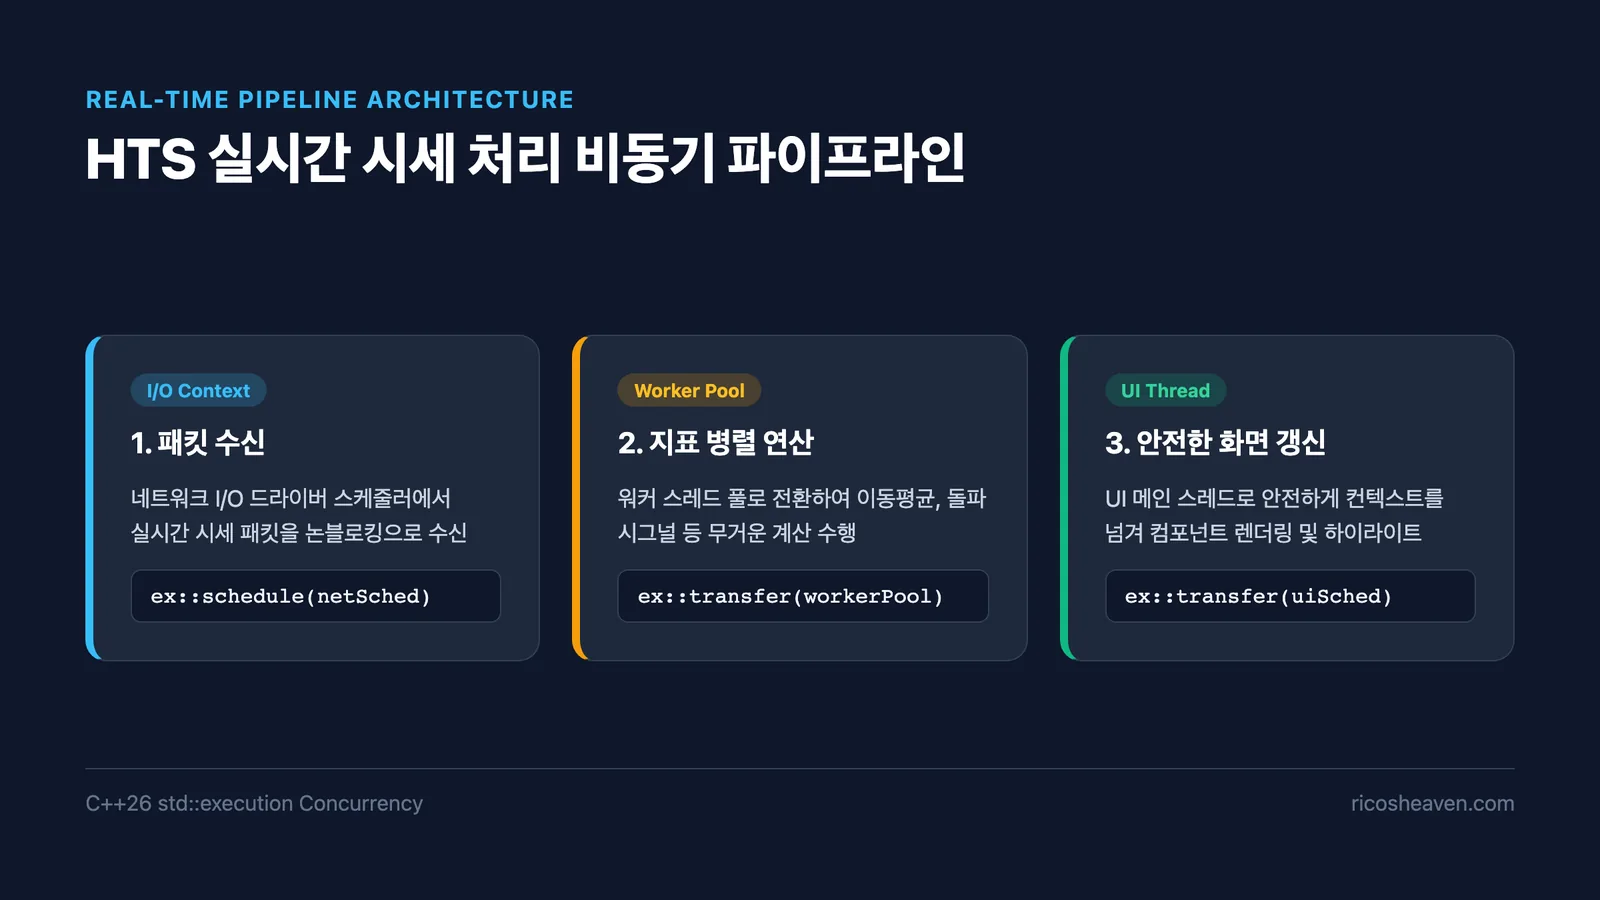
금융 HTS 시스템에서 네트워크 패킷 수신부터 이동평균 계산, UI 통지까지의 실시간 파이프라인을 std::execution으로 완벽히 구조화한 실무 코드입니다.
#include <execution>
#include <tuple>
#include <vector>

namespace ex = std::execution;

struct MarketTick {
    uint32_t symbolId;
    double price;
    uint64_t volume;
};

struct AnalyzedIndicator {
    uint32_t symbolId;
    double movingAverage;
    bool isBreakout;
};

// 실시간 시세 처리 파이프라인 생성 함수
auto CreateMarketDataPipeline(ex::scheduler auto netSched,
                             ex::scheduler auto workerPool,
                             ex::scheduler auto uiSched,
                             uint32_t targetSymbol)
{
    return ex::schedule(netSched)
        // 1. 네트워크 컨텍스트에서 시세 패킷 수신
        | ex::then([targetSymbol]() -> MarketTick {
            return NetworkDriver::FetchTick(targetSymbol);
        })
        // 2. 고성능 워커 스레드 풀로 전환하여 기술적 지표 병렬 계산
        | ex::transfer(workerPool)
        | ex::then([](const MarketTick& tick) -> AnalyzedIndicator {
            double ma20 = IndicatorEngine::CalculateMA(tick.symbolId, tick.price);
            bool breakout = tick.price > ma20 * 1.05;
            return AnalyzedIndicator{ tick.symbolId, ma20, breakout };
        })
        // 3. UI 스레드로 안전하게 전환하여 렌더링 갱신
        | ex::transfer(uiSched)
        | ex::then([](const AnalyzedIndicator& indicator) {
            if (indicator.isBreakout) {
                UIComponent::HighlightSignal(indicator.symbolId);
            }
            UIComponent::UpdatePriceView(indicator.symbolId, indicator.movingAverage);
        });
}
4.1 when_all을 활용한 다중 종목 병렬 수집 및 조인
여러 종목의 시세를 병렬로 동시에 가져와 단일 지표로 결합할 때는 when_all을 사용합니다.
auto multiFetch = ex::when_all(
    CreateMarketDataPipeline(netSched, workerPool, uiSched, 005930), // 삼성전자
    CreateMarketDataPipeline(netSched, workerPool, uiSched, 000660)  // SK하이닉스
)
| ex::then([](auto res1, auto res2) {
    std::cout << "Both tickers processed in parallel without lock contention!\n";
});
5. 기존 모델과의 종합 비교
| 비교 항목 | std::thread / std::future |
C++20 Coroutines | C++26 std::execution |
|---|---|---|---|
| 메모리 할당 | Shared State 힙 할당 강제 | 코루틴 프레임 힙 할당 (HALO 미보장 시) | 스택 기반 0-Allocation (인라인 합성) |
| 작업 합성성 | 거의 불가능 (블로킹 필요) | co_await 순차 합성 우수 |
파이프 연산자(|) 및 when_all 병렬 합성 극대화 |
| 취소(Cancellation) | 표준 지원 없음 | 별도 라이브러리 필요 | 언어 표준 set_stopped 취소 전파 |
| 스케줄러 추상화 | 없음 (OS 스레드 종속) | 커스텀 Awaiter 필요 | CPU/GPU/io_uring 범용 Scheduler 인터페이스 |
| 캐시 친화도 | 낮음 (포인터 인디렉션) | 보통 | 최상 (컴파일 타임 정적 구조체 평탄화) |
6. 결론: C++ 비동기 프로그래밍의 표준 완성
std::execution (P2300)은 C++ 언어에 마침내 완성된 진정한 의미의 비동기 프레임워크를 제공합니다:
- 무비용 추상화(Zero-Cost Abstraction): 힙 메모리 할당 없이 모든 비동기 상태를 스택 상의 템플릿 타입으로 평탄화하여 극한의 처리량을 보장합니다.
- 구조화된 동시성(Structured Concurrency): 비동기 작업의 시작, 완료, 에러, 취소가 단일 파이프라인 수명주기 내에서 완벽히 통제됩니다.
- 하드웨어 독립성: 동일한 비동기 알고리즘을 단 한 줄의 수정으로 CPU 스레드 풀, GPU 커널, 또는
io_uring비동기 I/O에서 구동할 수 있습니다.
현재 NVIDIA의 오픈소스 레퍼런스 구현체인 stdexec를 통해 C++20/C++23 환경에서도 즉시 이 모델을 도입할 수 있으므로, 고성능 분산 시스템 및 트레이딩 인프라를 구축하는 팀이라면 필수적으로 검토해야 할 표준 아키텍처입니다.
7. 자주 묻는 질문 (FAQ)
std::execution의 Sender는 코루틴 내에서 co_await sender 형태로 자연스럽게 대기할 수 있으며, 코루틴의 가독성과 Senders/Receivers의 제로 오버헤드 병렬 합성 성능을 결합하여 사용할 수 있습니다.
then, transfer 등)이 템플릿 래퍼 타입으로 컴파일 타임에 중첩 정의되기 때문입니다. connect 호출 시 전체 실행 상태(Operation State)가 단일 스택 객체로 결정되므로 런타임 힙 할당이 전혀 발생하지 않습니다.
stdexec (github.com/NVIDIA/stdexec)를 사용하면 C++20 이상의 표준 컴파일러(GCC 11+, Clang 13+, MSVC 2022+)에서 동일한 P2300 스펙의 Senders/Receivers 기능을 즉시 활용할 수 있습니다.